Buckets S3
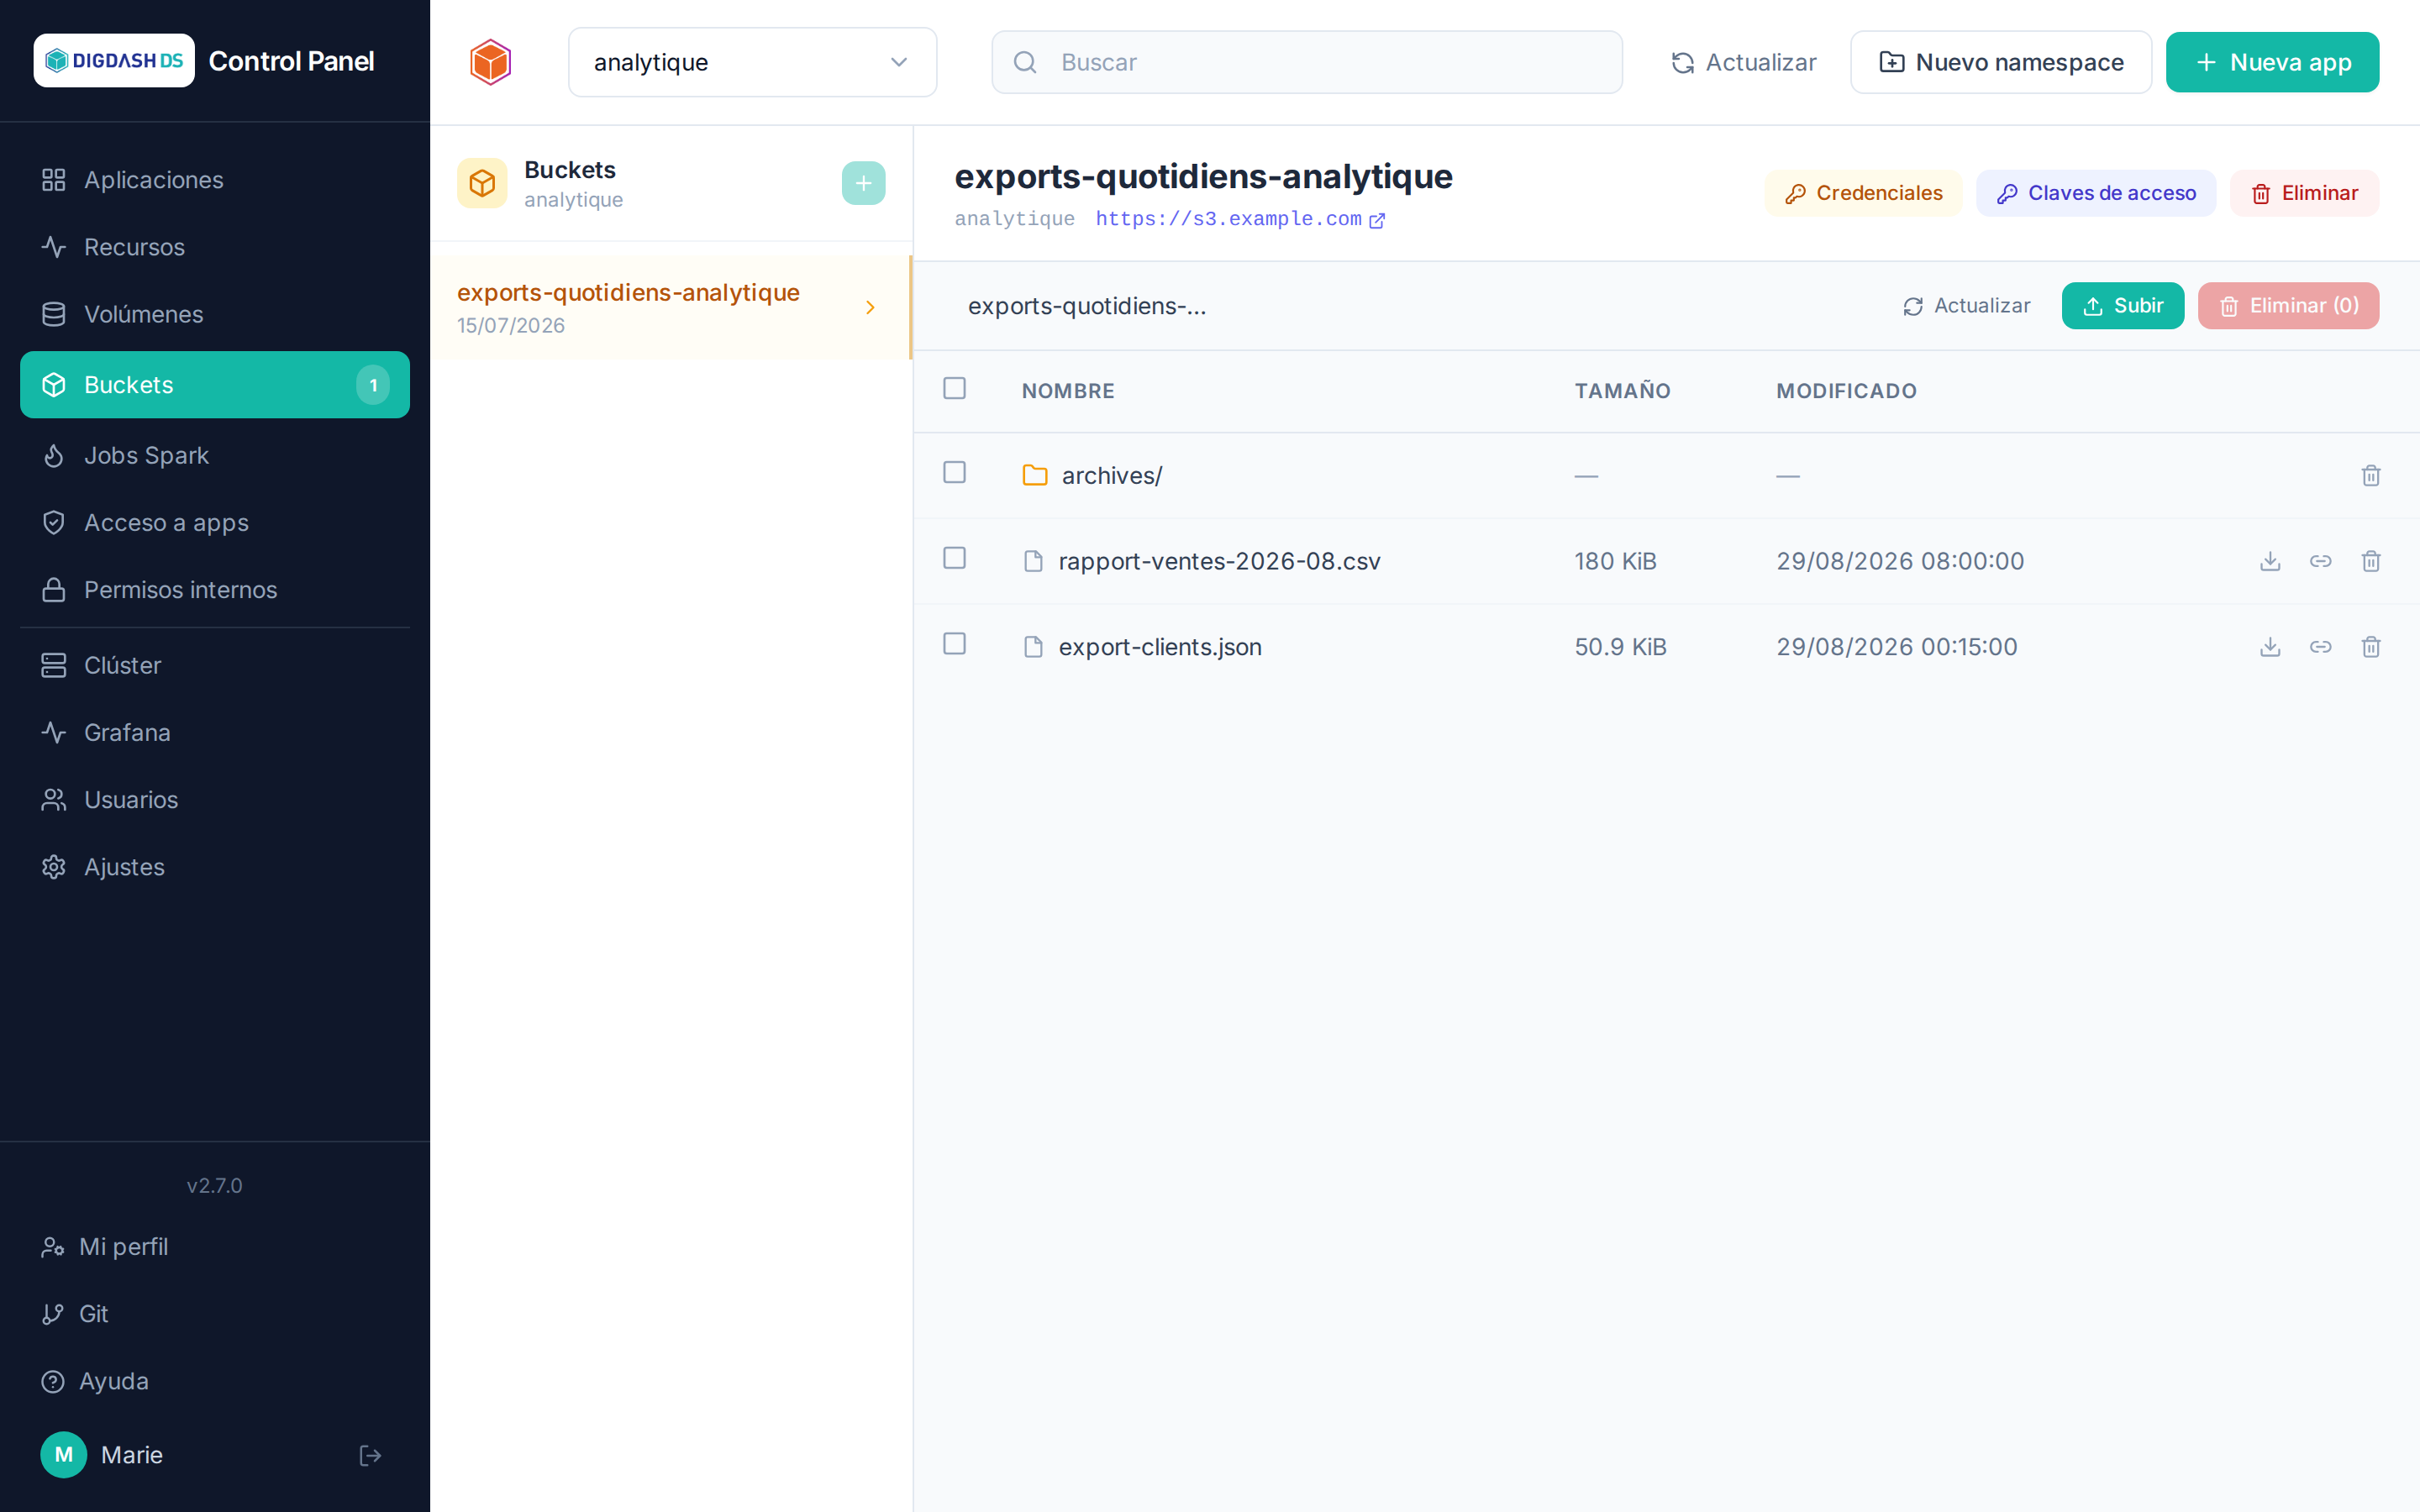
La página Buckets gestiona el almacenamiento de objetos S3 del namespace (servido por el propio clúster): repositorios de archivos, destinos de copias de seguridad, fuentes de datos para Apache Hop…
Tamaño y compresión
Cada bucket muestra su tamaño (suma de los tamaños de sus objetos), el tamaño realmente almacenado en Ceph tras la compresión, el ahorro de compresión cuando lo hay y su número de objetos. Estos valores proceden de la API de administración del almacenamiento de objetos (RGW) y se actualizan como máximo cada minuto; no aparecen si esa API no es accesible. Sin compresión activada en Ceph, tamaño y tamaño almacenado son idénticos.
Crear un bucket
Nuevo bucket → un nombre corto (letras minúsculas y dígitos). El bucket pasa por una fase de aprovisionamiento y luego se convierte en Bound — a partir de ahí es utilizable.
Credenciales de acceso
Cada bucket expone sus credenciales S3 (endpoint, access key, secret key) desde su fila en la lista. Estos son los valores que esperan:
- la sección Copia de seguridad de PostgreSQL y Digdash BI;
- cualquier cliente S3 externo (rclone, AWS CLI, DBeaver…).
Claves de acceso por aplicación
La pestaña Claves de acceso permite crear identidades S3 adicionales de alcance reducido (solo lectura o lectura/escritura) para confiar a una aplicación, en lugar de compartir las credenciales principales del bucket.
Explorar los objetos
El contenido de un bucket (archivos y carpetas) se consulta directamente desde la página — útil para comprobar que una copia de seguridad se ha escrito correctamente antes de iniciar una restauración.
Nueva carpeta crea una carpeta en la ubicación mostrada. Como S3 no tiene carpetas reales (una carpeta solo existe si contiene un objeto), el Control Panel deposita en ella un archivo de texto vacío .keep; la carpeta sigue visible mientras contenga este archivo u otro objeto.