Jobs Spark batch (Spark Operator)
Forma parte del lakehouse (visión general y esquema de interacciones).
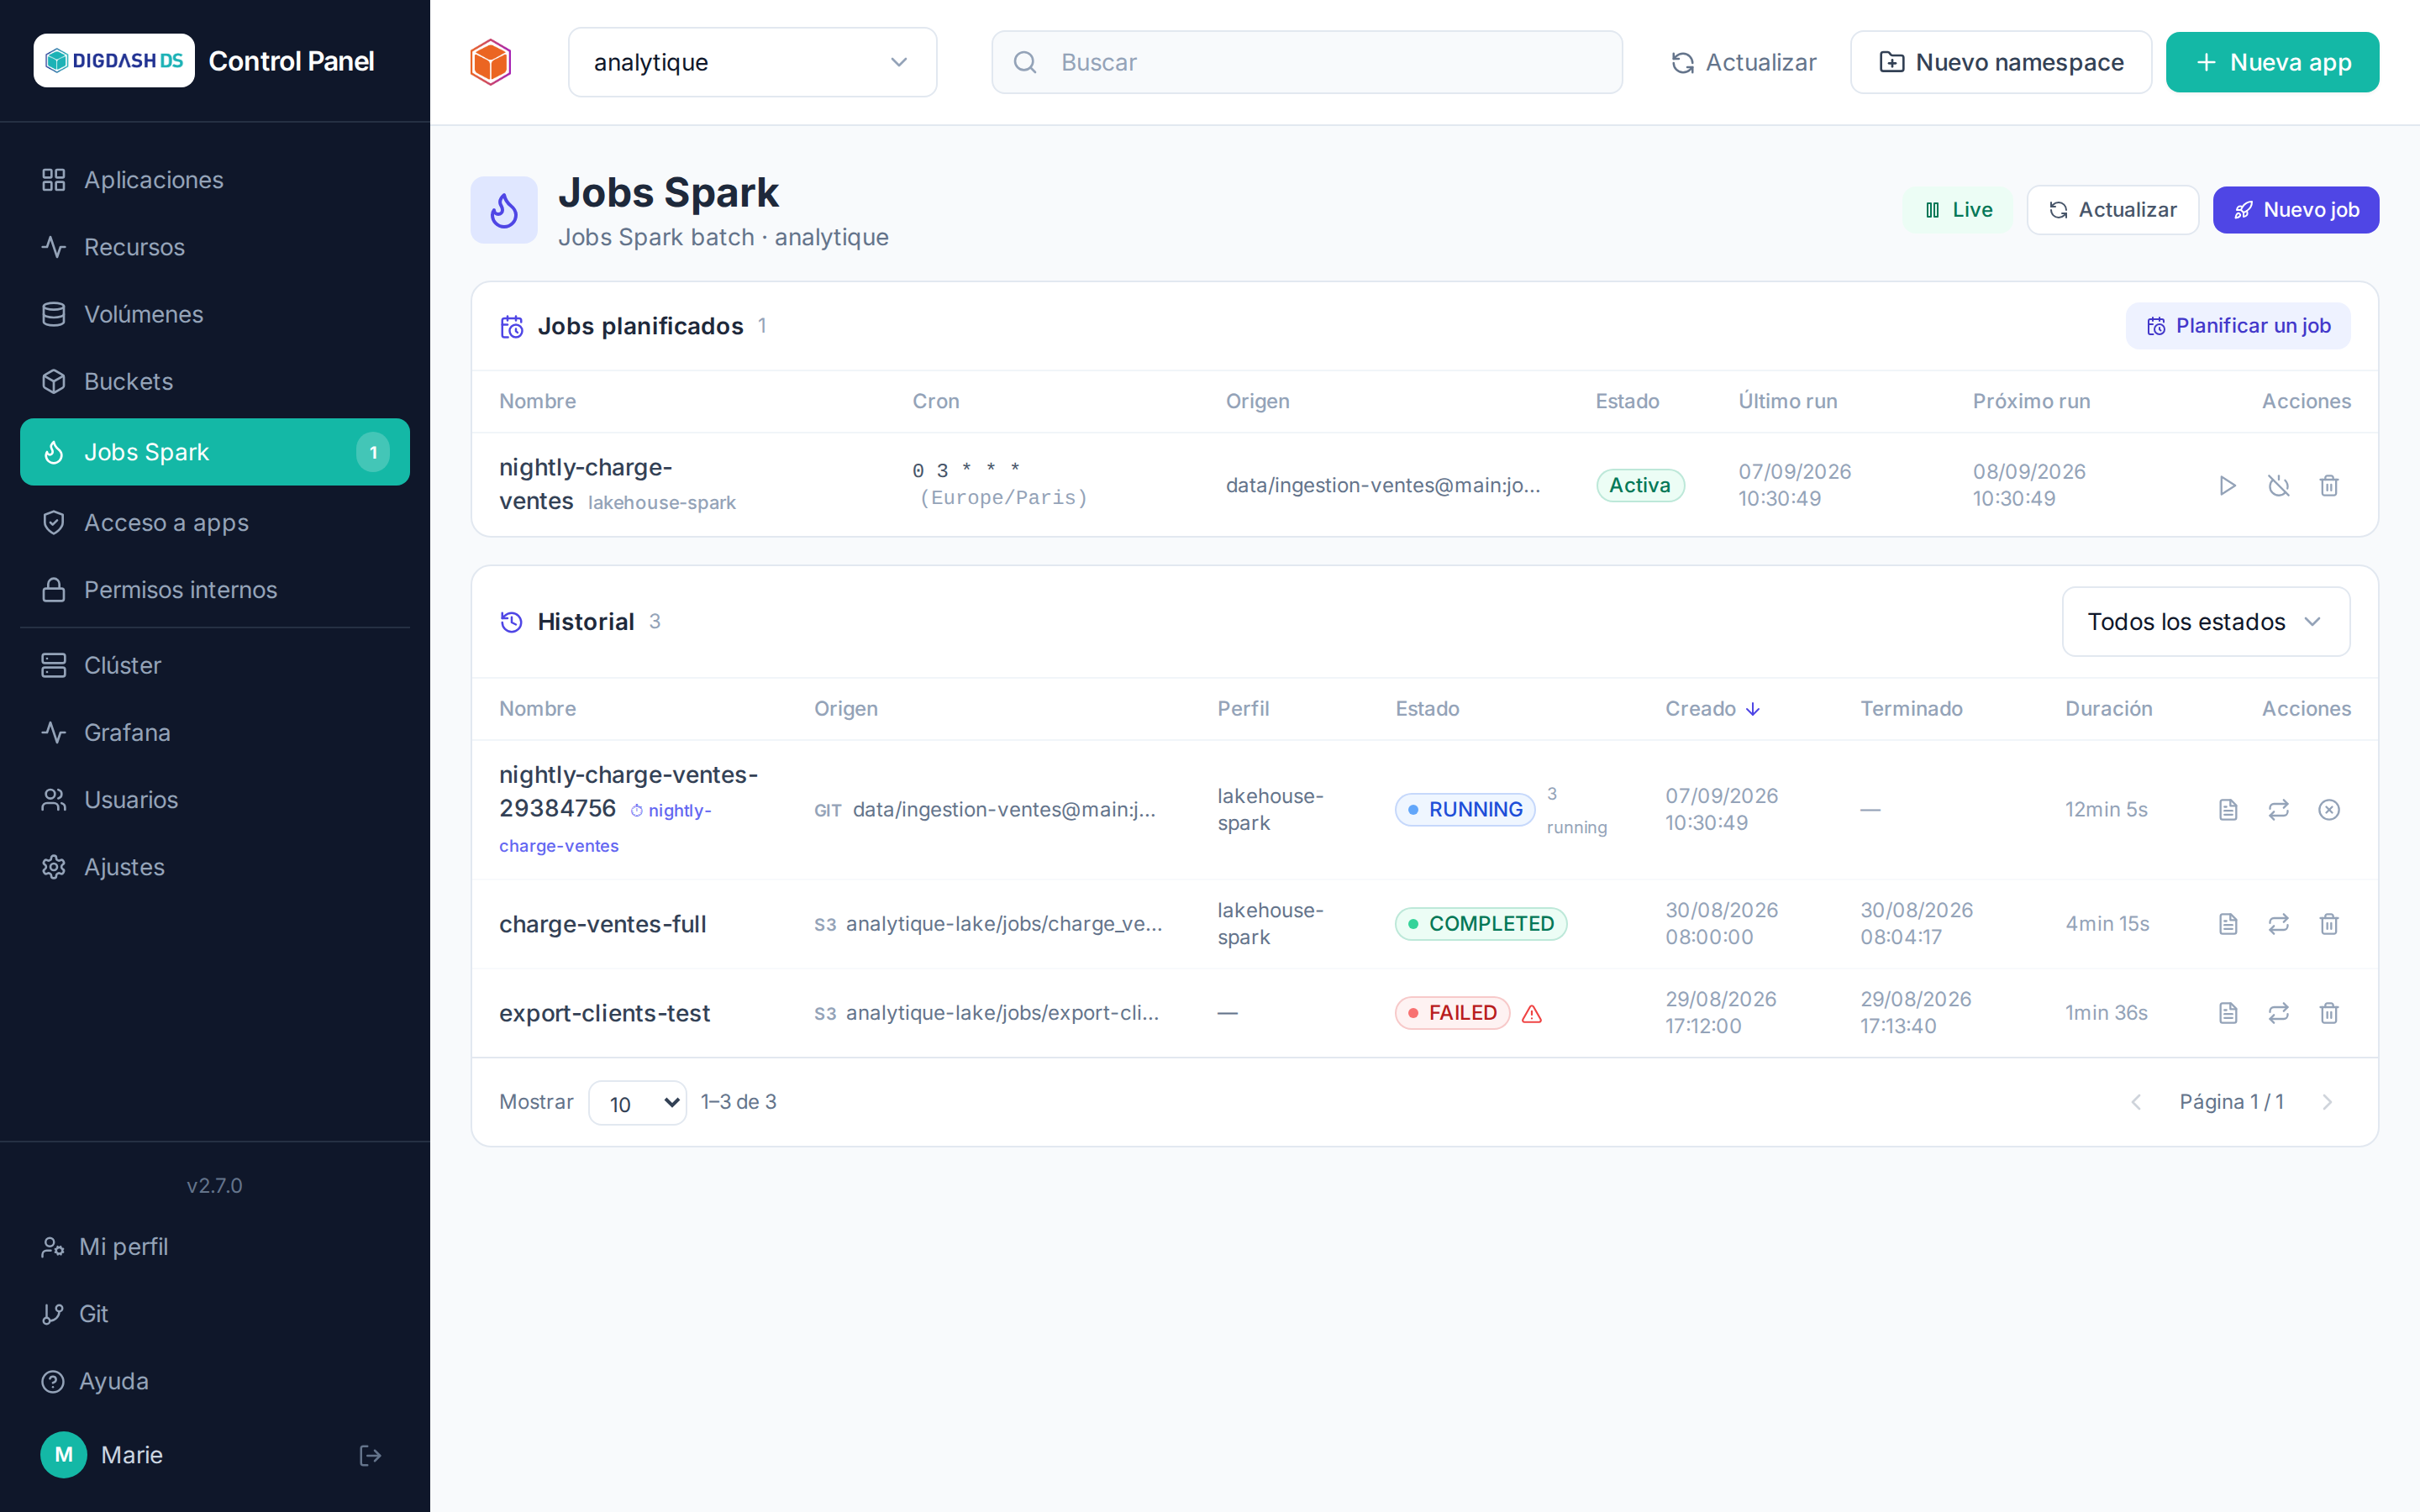
Para los tratamientos Spark autónomos o planificados (fuera de una sesión interactiva Spark Connect), la página Jobs Spark de la barra lateral lanza y sigue jobs batch en el namespace actual, mediante el Kubeflow Spark Operator instalado en la plataforma: cada job es un recurso Kubernetes SparkApplication del namespace (o ScheduledSparkApplication para una planificación cron); el operador lanza el driver y luego los ejecutores como pods, y limpia al final. El botón Jobs Spark de una tarjeta Spark Connect abre la misma página, filtrada en esa instancia como perfil.
Lanzar un job
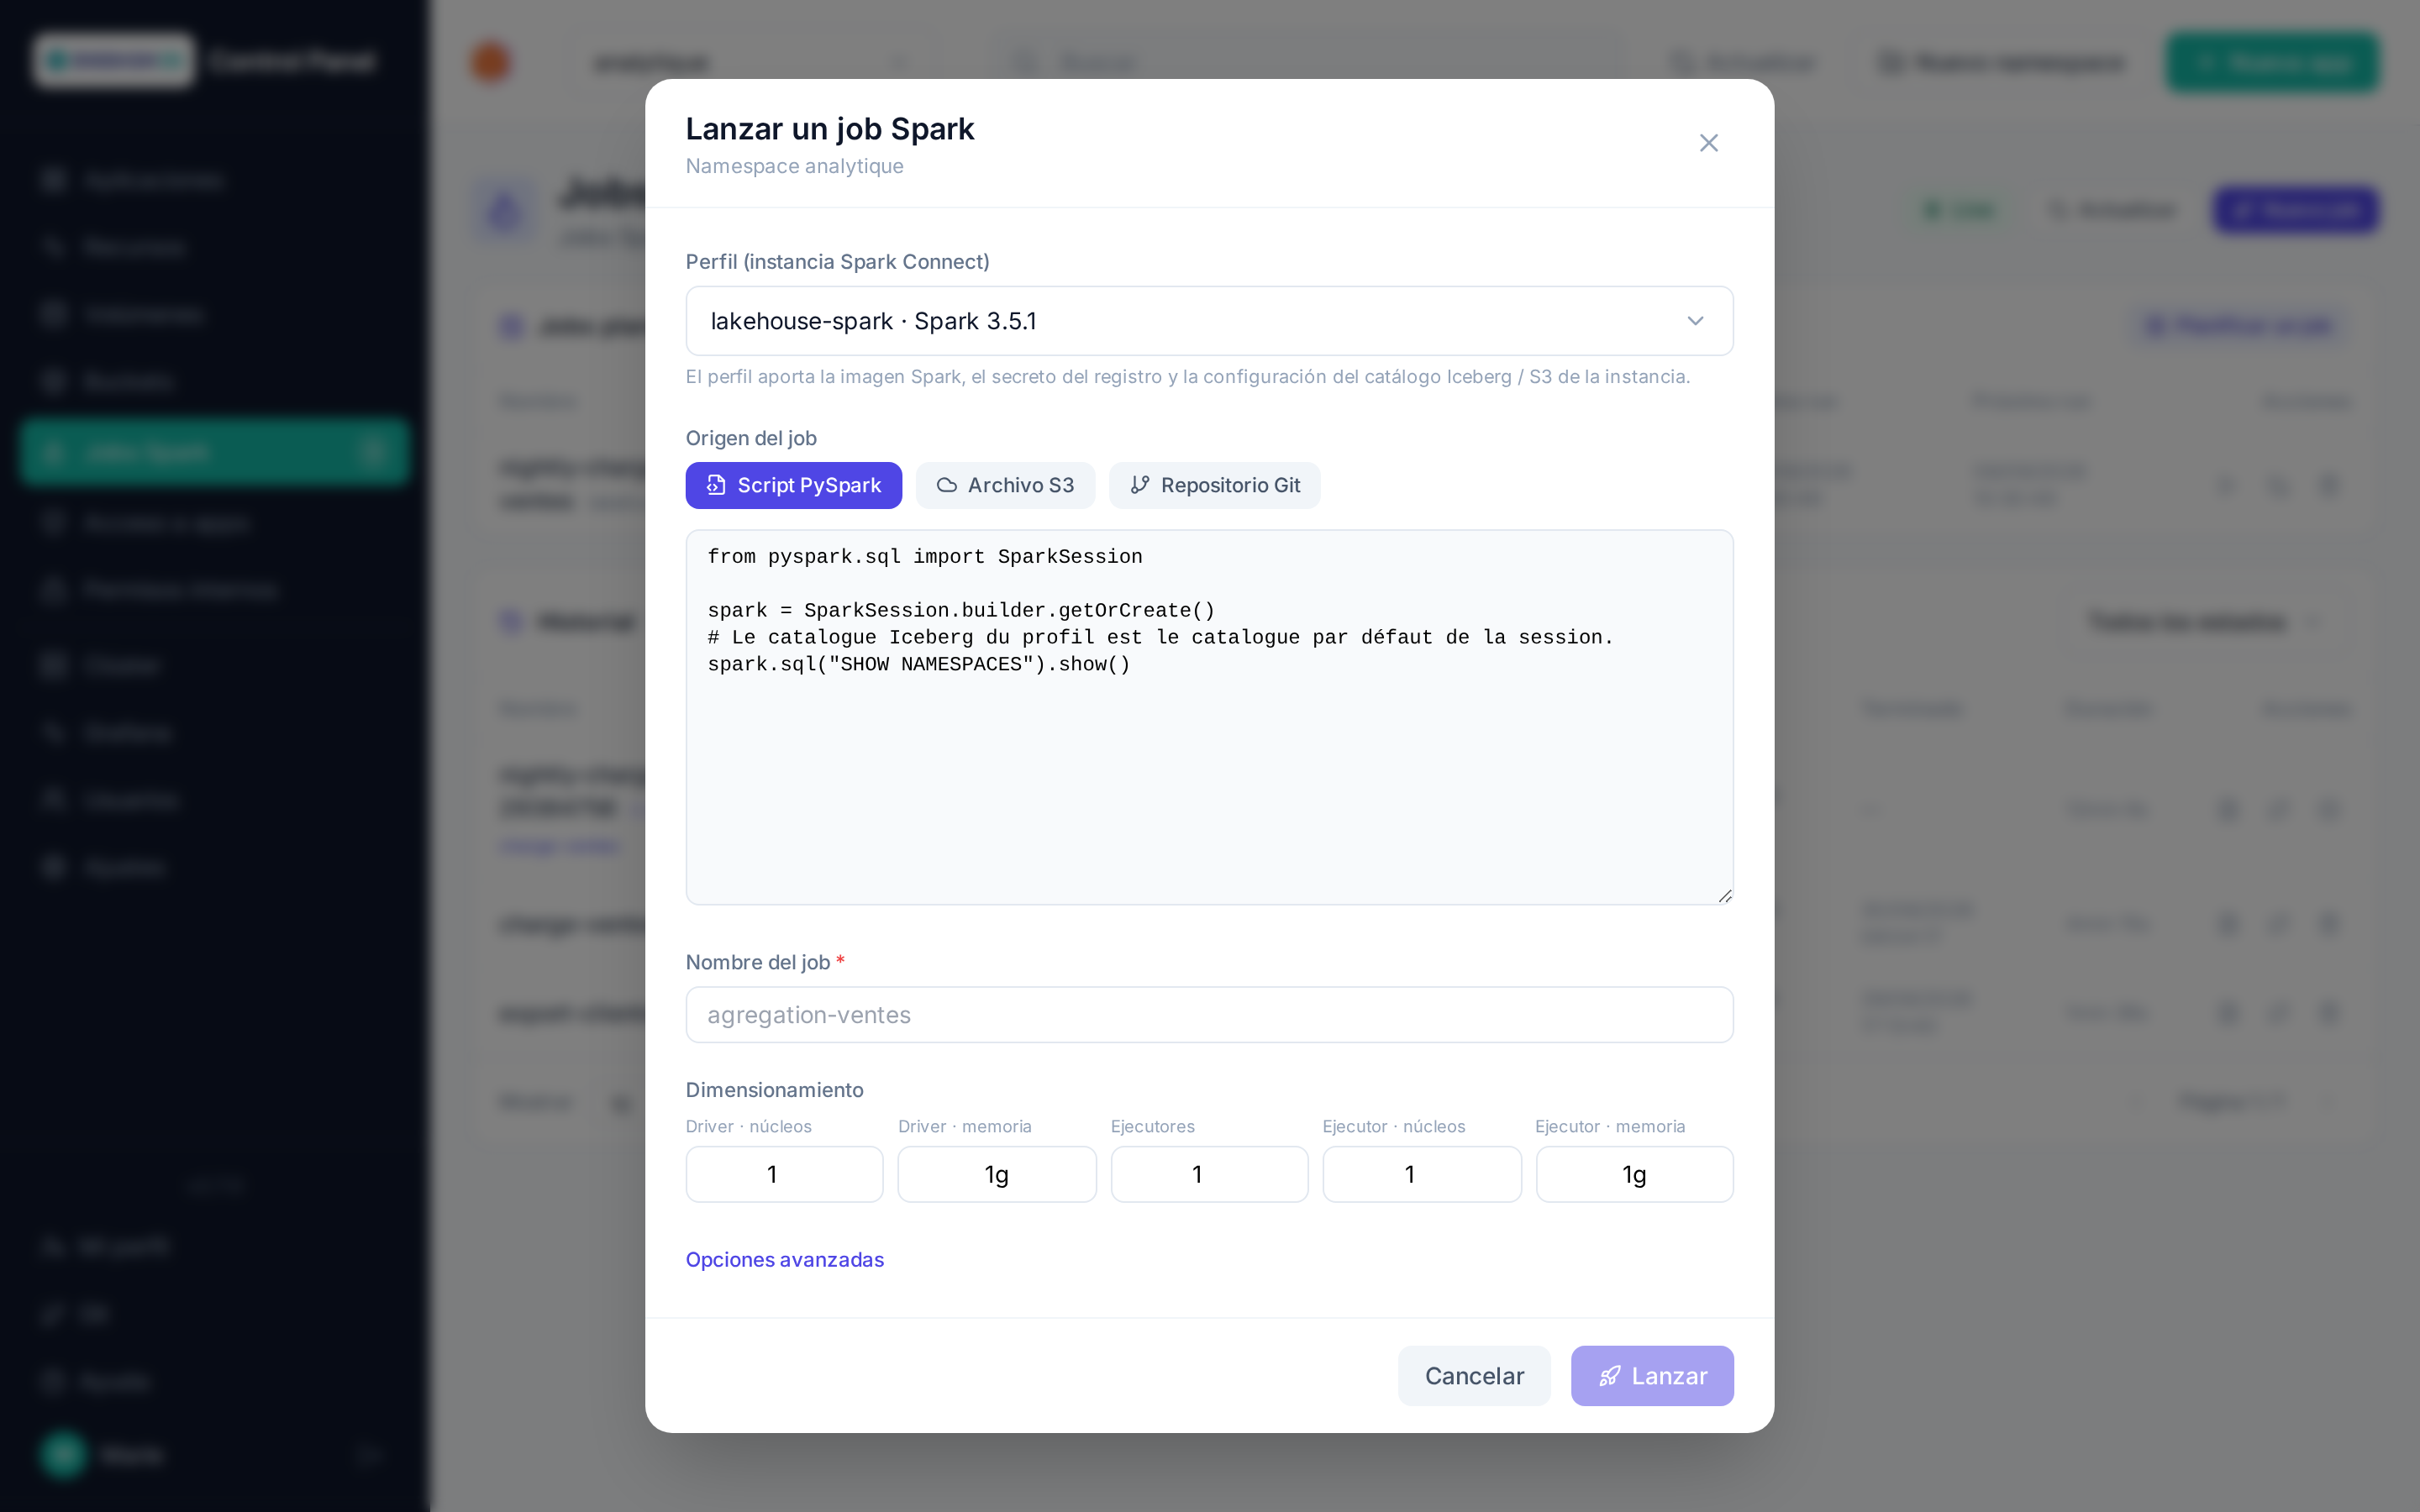
Nuevo job abre el formulario:
| Campo | Función |
|---|---|
| Perfil | Una instancia Spark Connect del namespace: el job reutiliza su imagen Spark (jars Iceberg incluidos), su secreto de registro y la configuración de su catálogo Apache Iceberg / S3 (catálogo por defecto de la sesión). Sin perfil, indique una imagen Spark explícita (y su secreto de registro). |
| Origen | El archivo principal del job: un script PySpark escrito directamente, un archivo S3 (bucket del namespace + ruta del objeto; endpoint y claves rellenados por el selector de bucket), o un archivo de un repositorio Git Forgejo (instancia, repositorio, rama, ruta — clonado con su token personal, véase Git). Una clase principal (opciones avanzadas) cambia a un job Scala/Java sobre un .jar. |
| Nombre | Identificador Kubernetes del job (minúsculas, cifras, guiones) — propuesto a partir del archivo. |
| Dimensionamiento | Núcleos y memoria del driver, número de ejecutores, núcleos y memoria por ejecutor. |
| Opciones avanzadas | Argumentos, propiedades Spark adicionales (spark.*), retención del recurso tras el fin — en horas, 168 (7 días) por defecto. |
El driver se ejecuta con la cuenta de servicio spark del namespace (límites de CPU/memoria en cada contenedor, como exige la cuota del namespace); los orígenes S3 y Git los recupera un initContainer (aws s3 cp / git clone) en un volumen montado en /opt/job, y el script escrito mediante un ConfigMap sparkjob-<nombre>. Las credenciales (catálogo, S3, Git) permanecen en Secretos del namespace, nunca en el formulario anotado en el recurso.
Seguimiento
El historial lista los jobs del namespace con su estado (SUBMITTED, RUNNING, COMPLETED, FAILED…), su origen, su perfil y su duración; se refresca solo mientras un job está activo. Para cada job:
- Detalle y logs: pods driver/ejecutores y últimas líneas del driver, en directo mientras el job se ejecuta;
- Relanzar tal cual: nuevo recurso
<nombre>-<sufijo>a partir del formulario original (perfil resuelto de nuevo, es decir imagen y configuración al día); Relanzar con cambios reabre el formulario prerrellenado; - Cancelar (job activo) detiene driver y ejecutores; Eliminar (job terminado) retira el recurso y sus logs.
Se aplican los roles habituales: lectura para un viewer, lanzamiento/cancelación/eliminación para un operator, planificación para un admin del namespace.
Jobs planificados
Planificar un job reutiliza el formulario de lanzamiento con una expresión cron (5 campos), una zona horaria, una política de concurrencia (prohibir solapamientos, permitir, reemplazar) y el número de runs conservados. Cada planificación puede lanzarse ahora, suspenderse y reactivarse, o eliminarse; sus runs aparecen en el historial con el marcador ⏱ del nombre de la planificación.
Sin la interfaz
Los recursos siguen siendo manipulables con kubectl -n <namespace> get sparkapplications: un job creado a mano aparece en el historial (cancelación/eliminación posibles, pero sin relanzamiento al no existir formulario original). En un clúster sin acceso a Docker Hub, las imágenes de los initContainers se sobrescriben en Parámetros del clúster: SPARK_JOB_GIT_IMAGE (por defecto alpine/git) y SPARK_JOB_S3_IMAGE (por defecto amazon/aws-cli).
Namespaces creados antes del operador
La cuenta de servicio spark se crea con cada namespace y se comprueba en cada lanzamiento; para los namespaces anteriores a la instalación del operador, la instalación también la crea (o python manage.py ensure_spark_rbac en ControlPanel).