Buckets S3
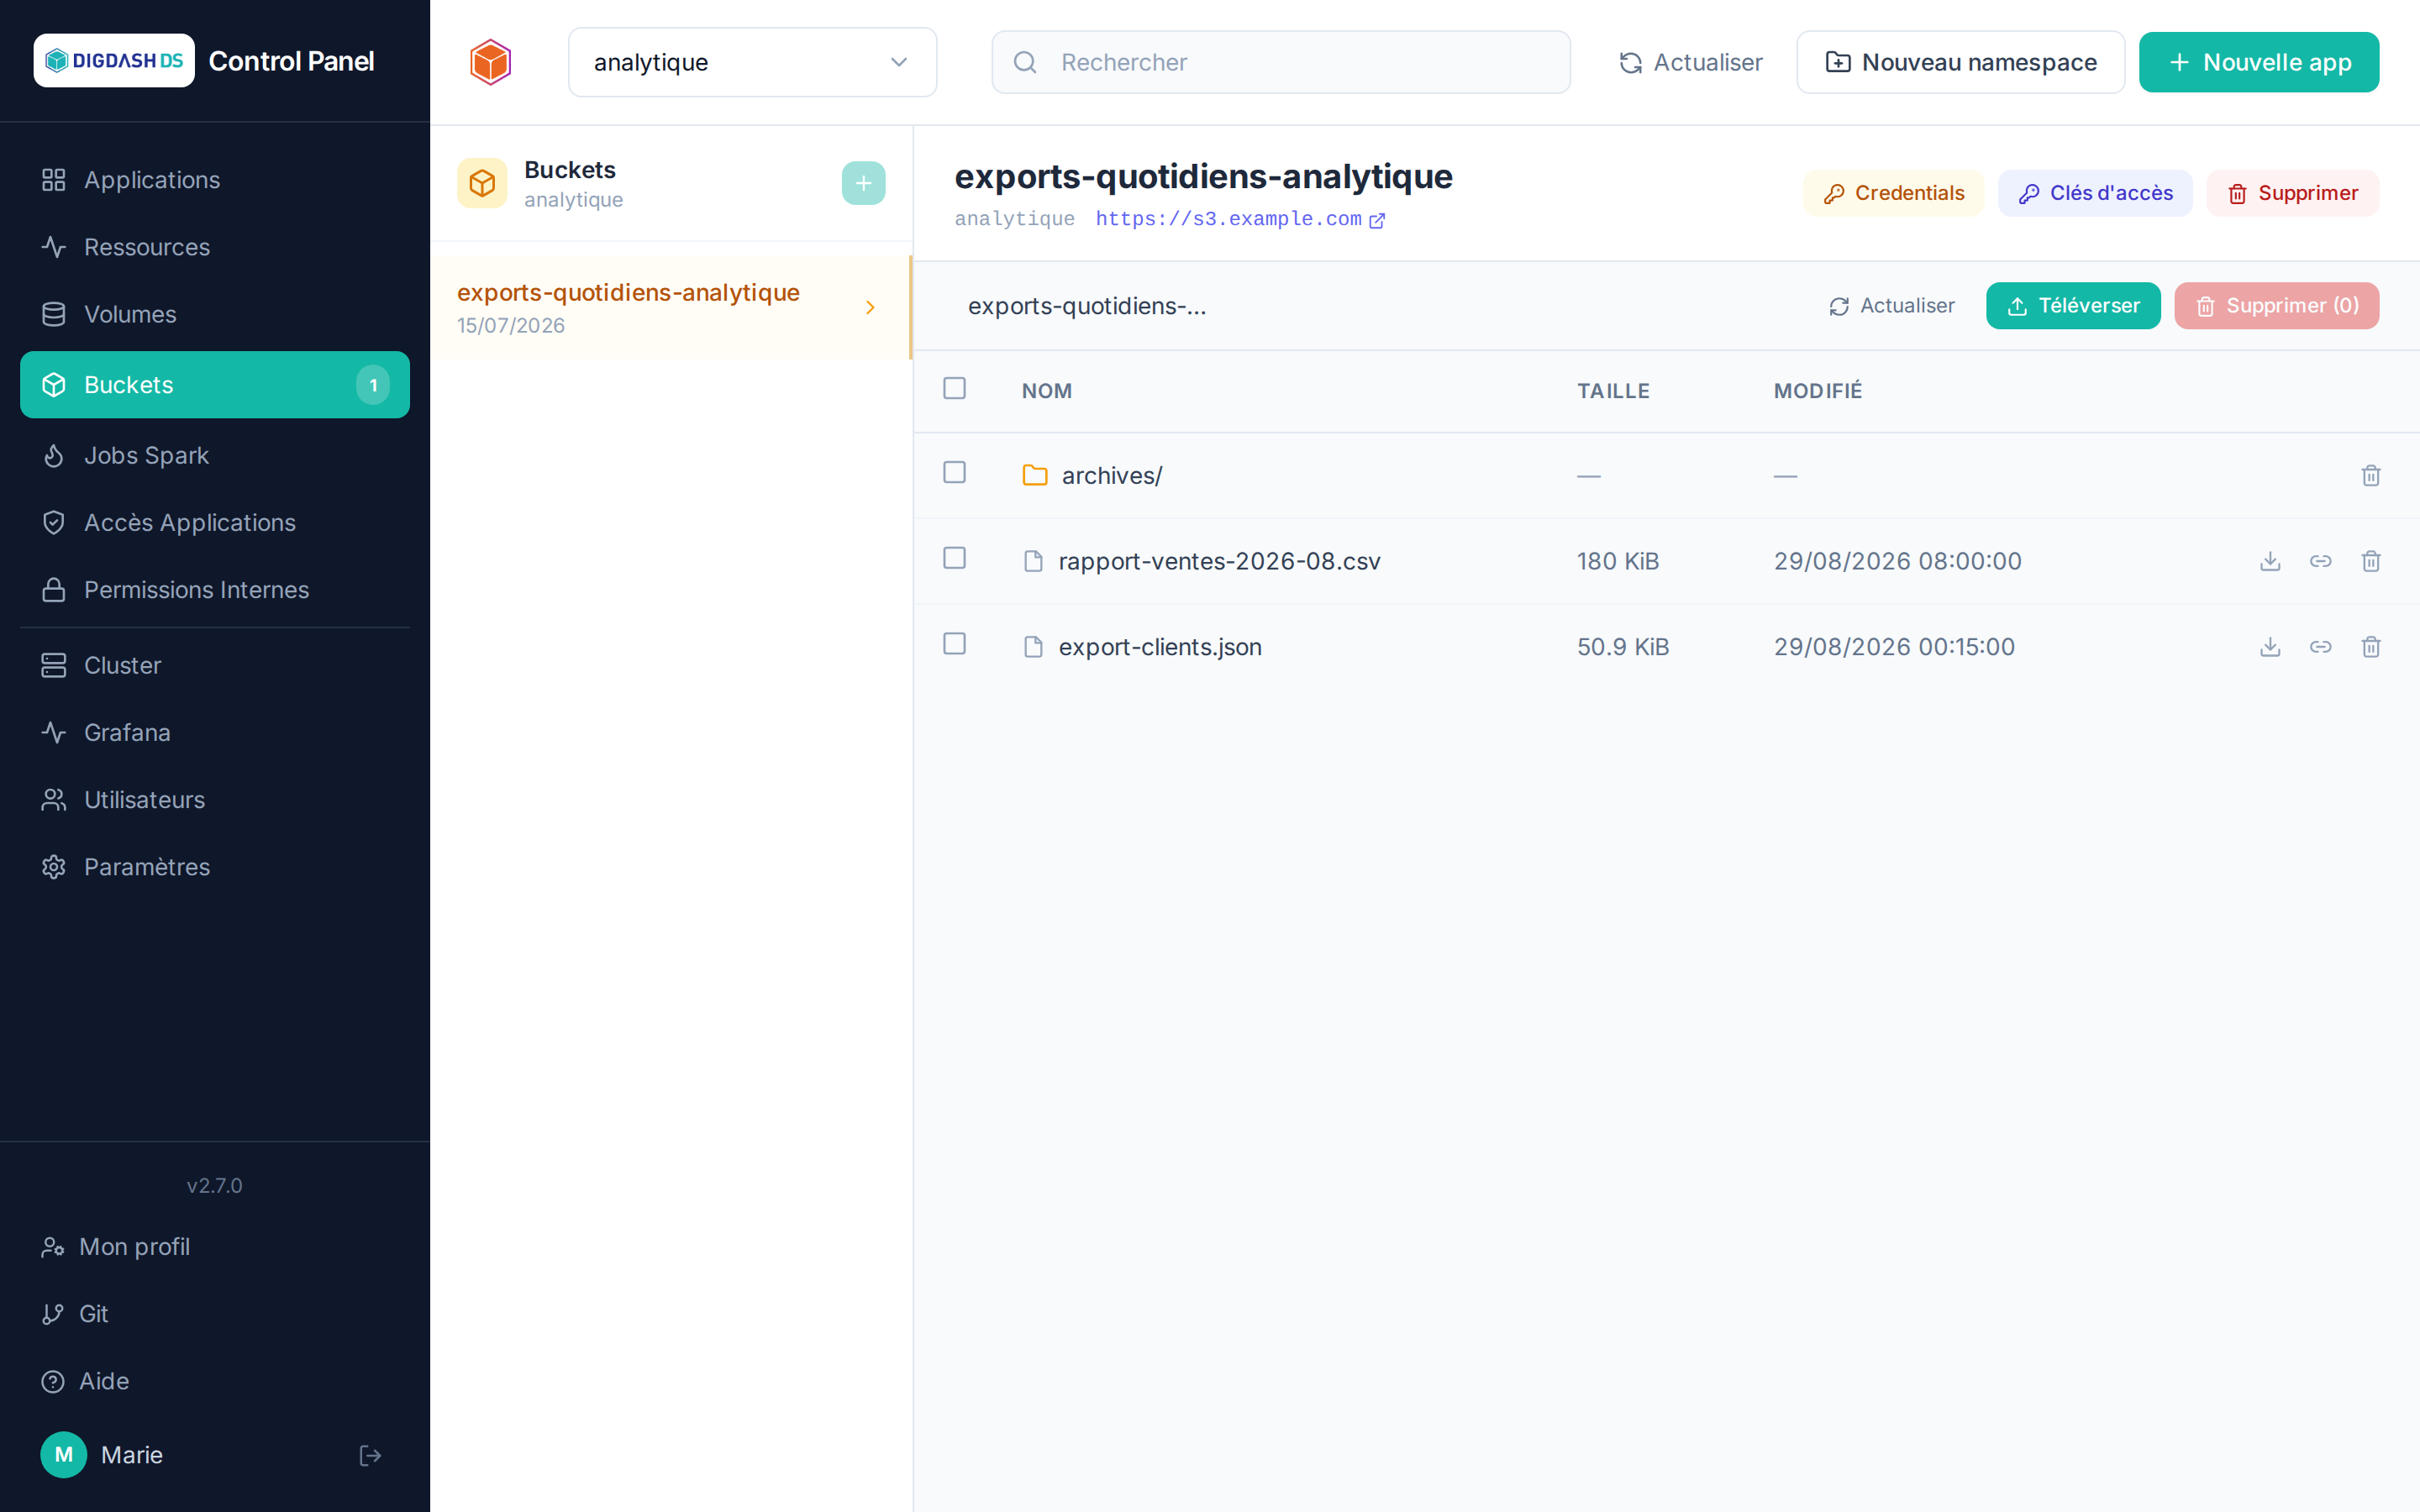
La page Buckets gère le stockage objet S3 du namespace (servi par le cluster lui-même) : dépôts de fichiers, cibles de sauvegarde, sources de données pour Apache Hop…
Taille et compression
Chaque bucket affiche sa taille (somme des tailles de ses objets), la taille réellement stockée dans Ceph après compression, le gain de compression lorsqu'il y en a un, et son nombre d'objets. Ces valeurs viennent de l'API d'administration du stockage objet (RGW) et sont actualisées au plus toutes les minutes ; elles n'apparaissent pas si cette API n'est pas joignable. Sans compression activée côté Ceph, taille et taille stockée sont identiques.
Créer un bucket
Nouveau bucket → un nom court (lettres minuscules et chiffres). Le bucket passe par une phase de provisionnement puis devient Bound — il est alors utilisable.
Identifiants d'accès
Chaque bucket expose ses identifiants S3 (endpoint, access key, secret key) depuis sa ligne dans la liste. Ce sont ces valeurs qu'attendent :
- la section Sauvegarde de PostgreSQL et Digdash BI ;
- tout client S3 externe (rclone, AWS CLI, DBeaver…).
Clés d'accès par application
L'onglet Clés d'accès permet de créer des identités S3 supplémentaires à portée réduite (lecture seule ou lecture/écriture) à confier à une application, plutôt que de partager les identifiants principaux du bucket.
Parcourir les objets
Le contenu d'un bucket (fichiers et dossiers) se consulte directement depuis la page — utile pour vérifier qu'une sauvegarde a bien été écrite avant de lancer une restauration.
Nouveau dossier crée un dossier à l'emplacement affiché. S3 n'ayant pas de vrais dossiers (un dossier n'existe que s'il contient un objet), le Control Panel y dépose un fichier texte vide .keep ; le dossier reste visible tant que ce fichier ou un autre objet s'y trouve.