Clúster
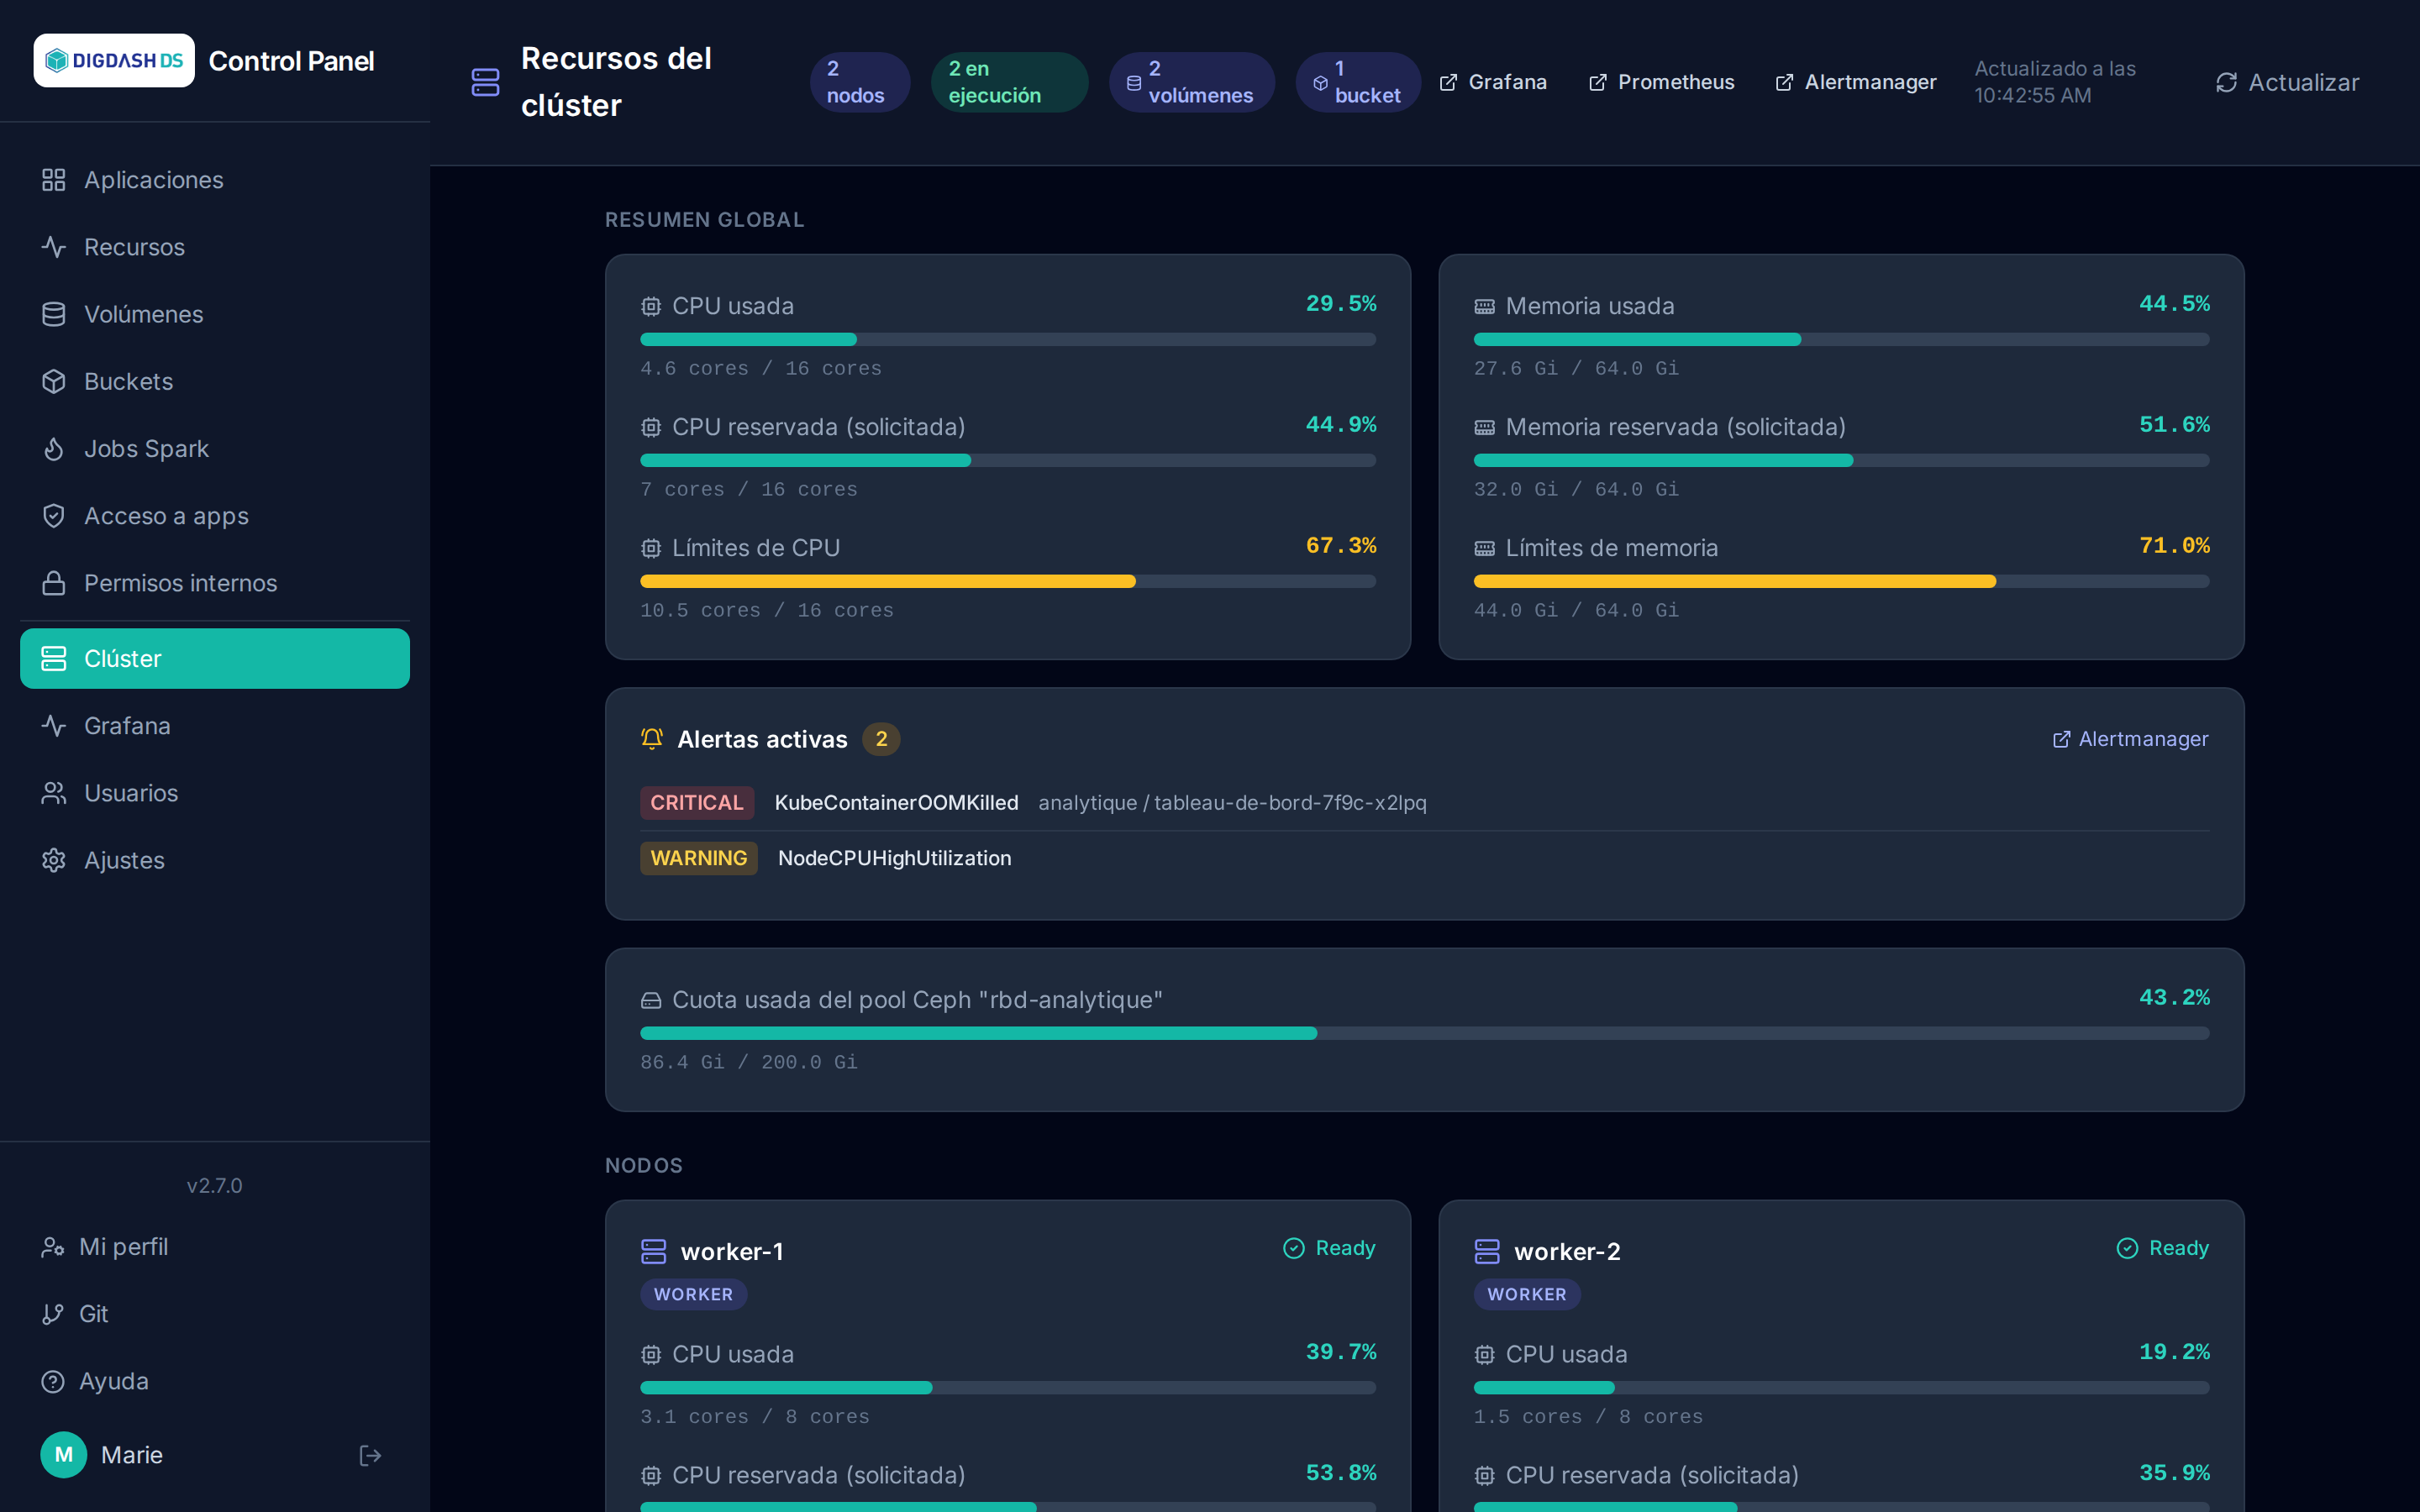
La página Clúster (reservada a los administradores de plataforma) ofrece una vista global, en tiempo real, de los recursos Kubernetes de toda la plataforma — de todos los namespaces. Se actualiza automáticamente cada 30 segundos, o de inmediato mediante Actualizar.
La cabecera muestra cuatro indicadores rápidos: el número de nodos, el número de pods en ejecución, y el total de volúmenes y de buckets de la plataforma, de todos los namespaces.
Resumen global
Tres indicadores por recurso (CPU y memoria), en relación con la capacidad total del clúster:
| Indicador | Significado |
|---|---|
| Usado | Consumo real medido por el servidor de métricas |
| Solicitado (requests) | Suma de las cantidades solicitadas por todos los pods — lo que Kubernetes garantiza |
| Límites | Suma de los topes configurados — puede superar la capacidad real (sobreasignación), a vigilar |
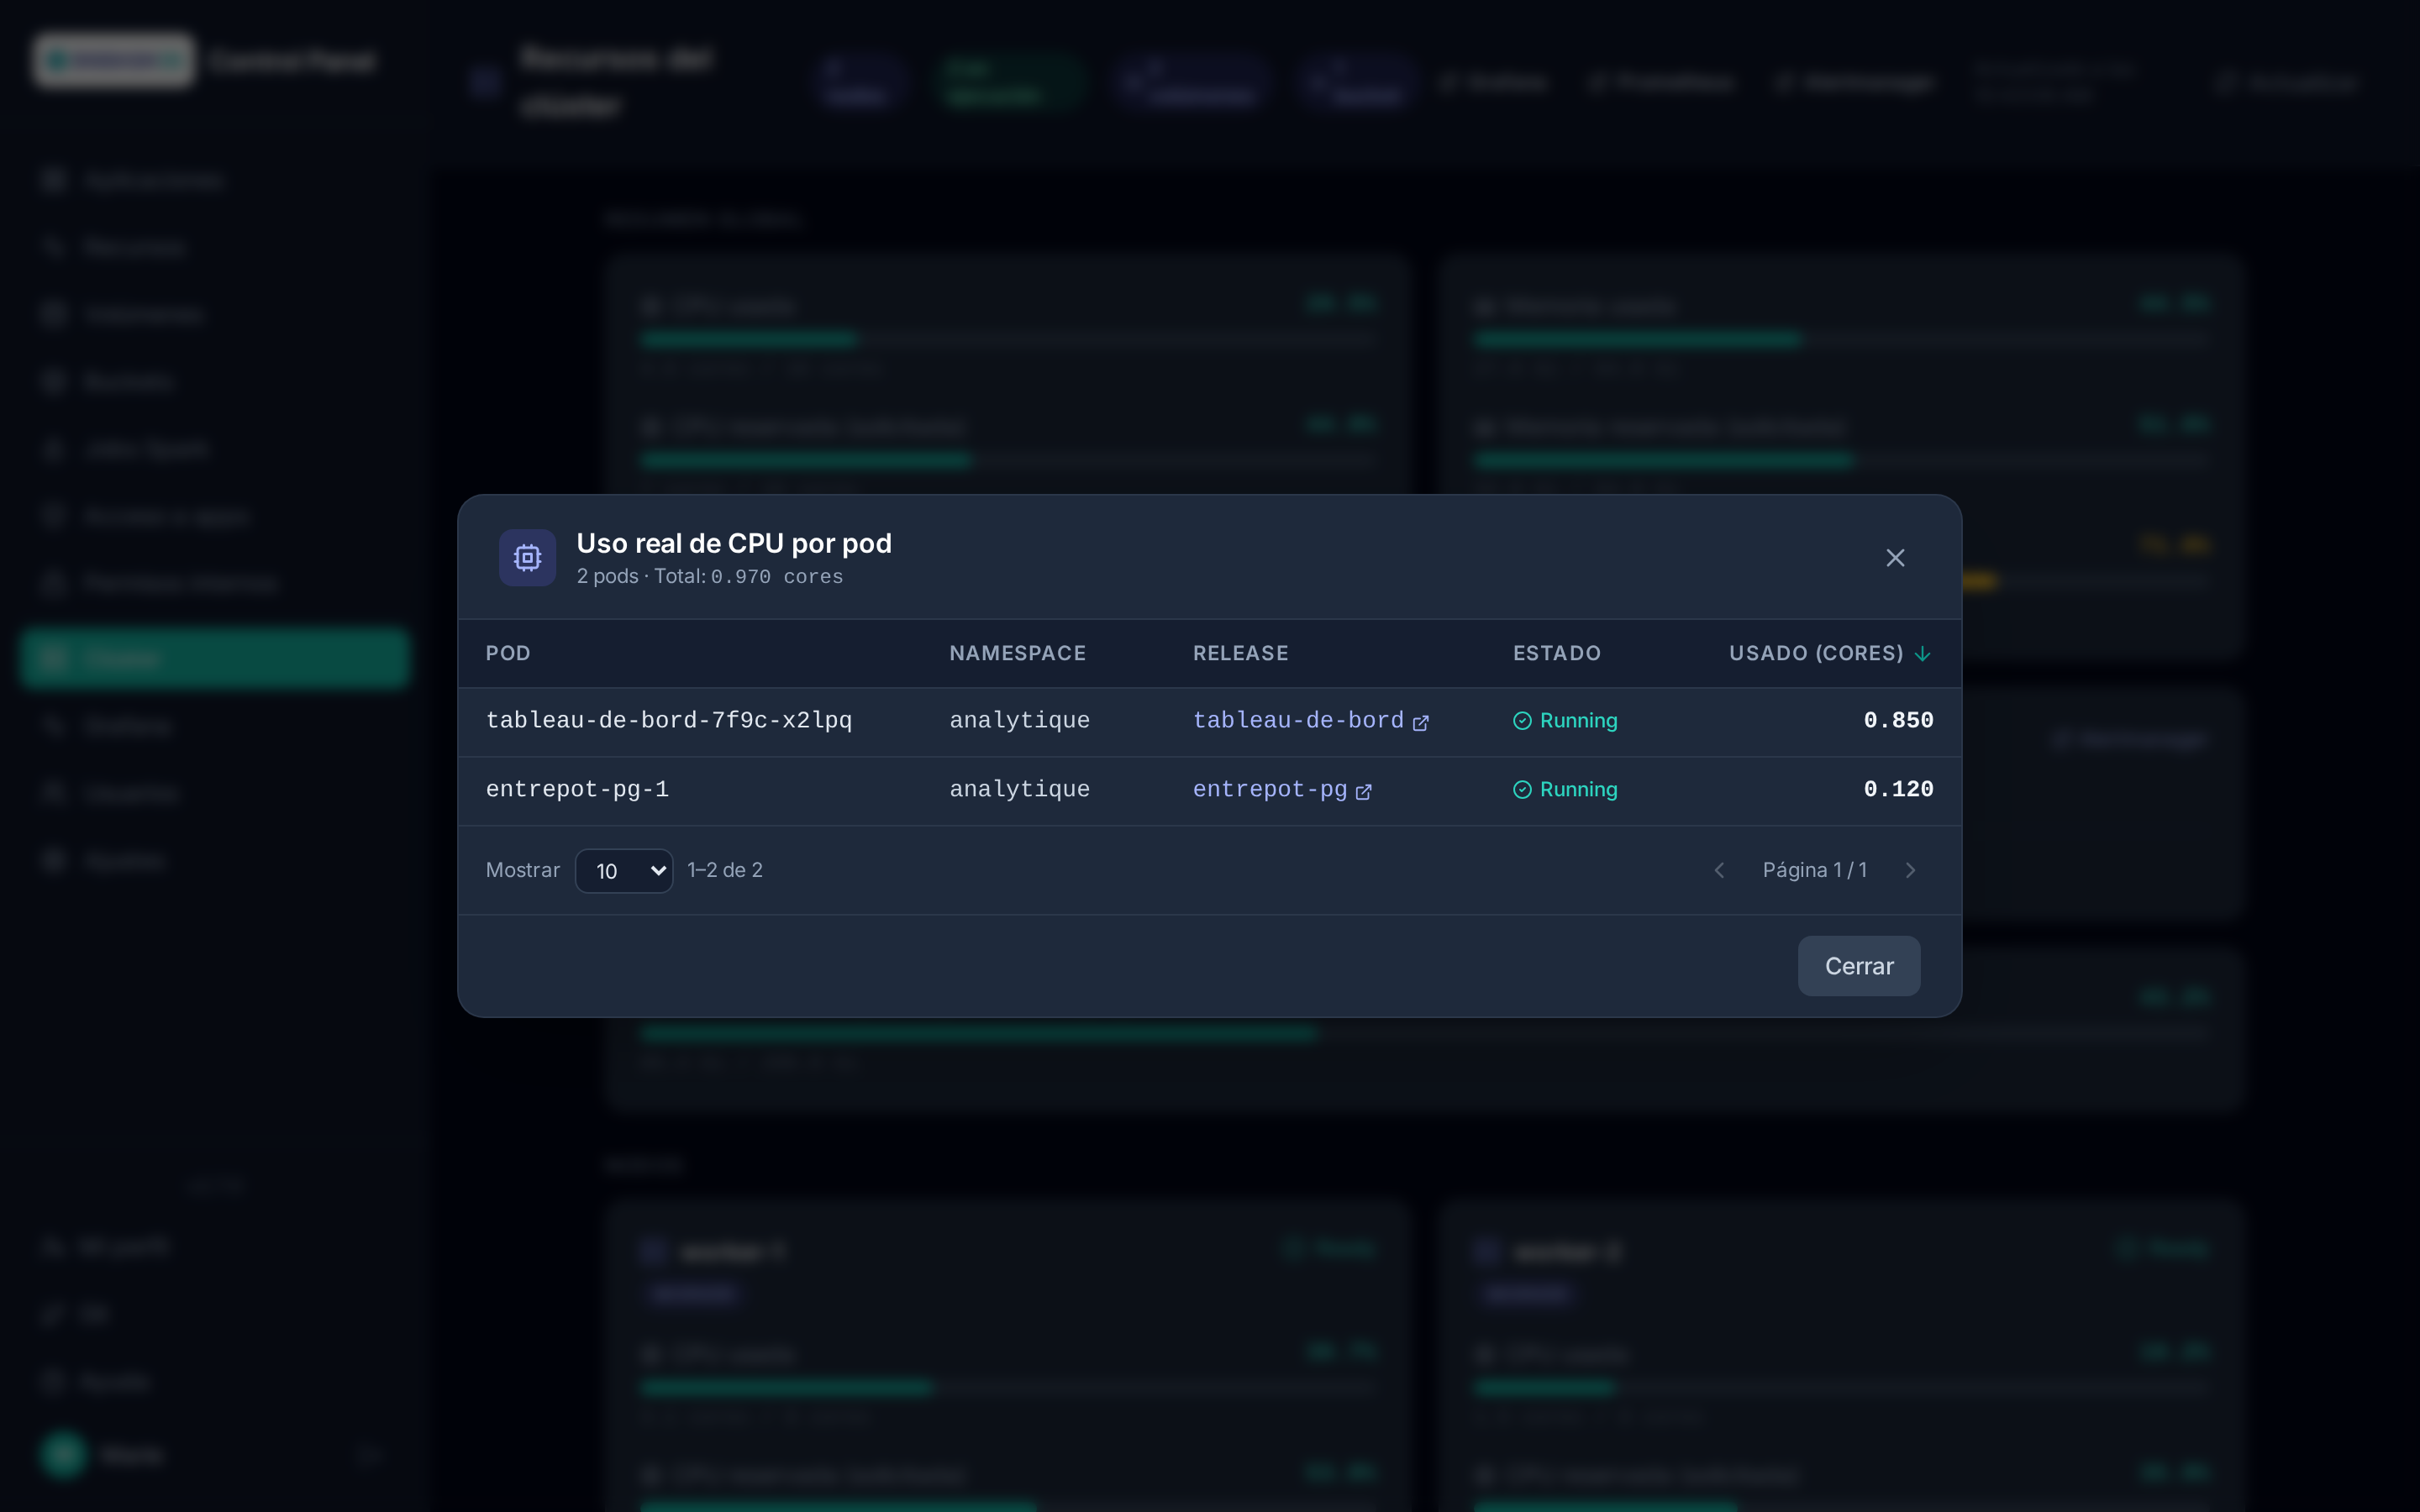
Al hacer clic en la etiqueta de un indicador se abre el desglose por pod: la lista de todos los pods del clúster ordenada por consumo, con un enlace directo a la aplicación correspondiente cuando el pod pertenece a una release gestionada por el Control Panel.
Almacenamiento
Una tarjeta de almacenamiento Ceph completa el resumen global cuando la información está disponible. Muestra, según lo que se haya podido determinar:
- la cuota del pool Ceph RBD aplicativo y su ocupación, si ese pool tiene una cuota fijada;
- en su defecto, la ocupación del pool en relación con la capacidad total del clúster Ceph, si el pool no tiene cuota;
- como último recurso, la capacidad global del clúster Ceph (Rook), si no se ha podido determinar el pool aplicativo.
La tarjeta no aparece si ninguna de estas informaciones está disponible (por ejemplo, si la CLI ceph no está accesible).
Supervisión
Cuando la pila de supervisión de la plataforma (Prometheus, Grafana, Alertmanager) está instalada, la cabecera de la página ofrece tres enlaces externos Grafana, Prometheus y Alertmanager (autenticación con la cuenta de plataforma habitual), y una tarjeta Alertas activas lista las alertas Prometheus en curso (firing), las más graves primero, con su namespace y el pod afectado.
La misma pila alimenta también, en otros lugares del Control Panel:
- la columna Usado de la página Volúmenes;
- el enlace Métricas de las tarjetas de aplicación (dashboard Grafana del pod o del namespace) — ver Aplicaciones;
- el banner n alertas activas encima del panel de un namespace;
- el enlace Grafana de la barra lateral.
Si Prometheus no es accesible desde el Control Panel, los enlaces siguen visibles pero la tarjeta lo indica y los valores derivados (alertas, consumo de volúmenes) se muestran como no disponibles (n/d). Las URL públicas (GRAFANA_URL, PROMETHEUS_PUBLIC_URL, ALERTMANAGER_URL) y la dirección interna de Prometheus (PROMETHEUS_URL) pueden sobrescribirse en Parámetros del clúster.
Nodos
Cada nodo del clúster se presenta con su estado (Ready o no), sus roles, y los mismos seis indicadores (CPU/memoria × usado/solicitado/límites) en relación con su propia capacidad — útil para detectar un nodo desequilibrado antes de que el scheduler de Kubernetes tenga dificultades para ubicar nuevos pods en él.
Note
Estos indicadores ofrecen una vista completa de la plataforma, incluidas las cargas que no son aplicaciones del catálogo (componentes del sistema, otros servicios del clúster). Para el detalle de los recursos de un solo namespace, véase la tarjeta de aplicación correspondiente en el panel de control.