Lakehouse: Apache Iceberg, Trino y JupyterHub
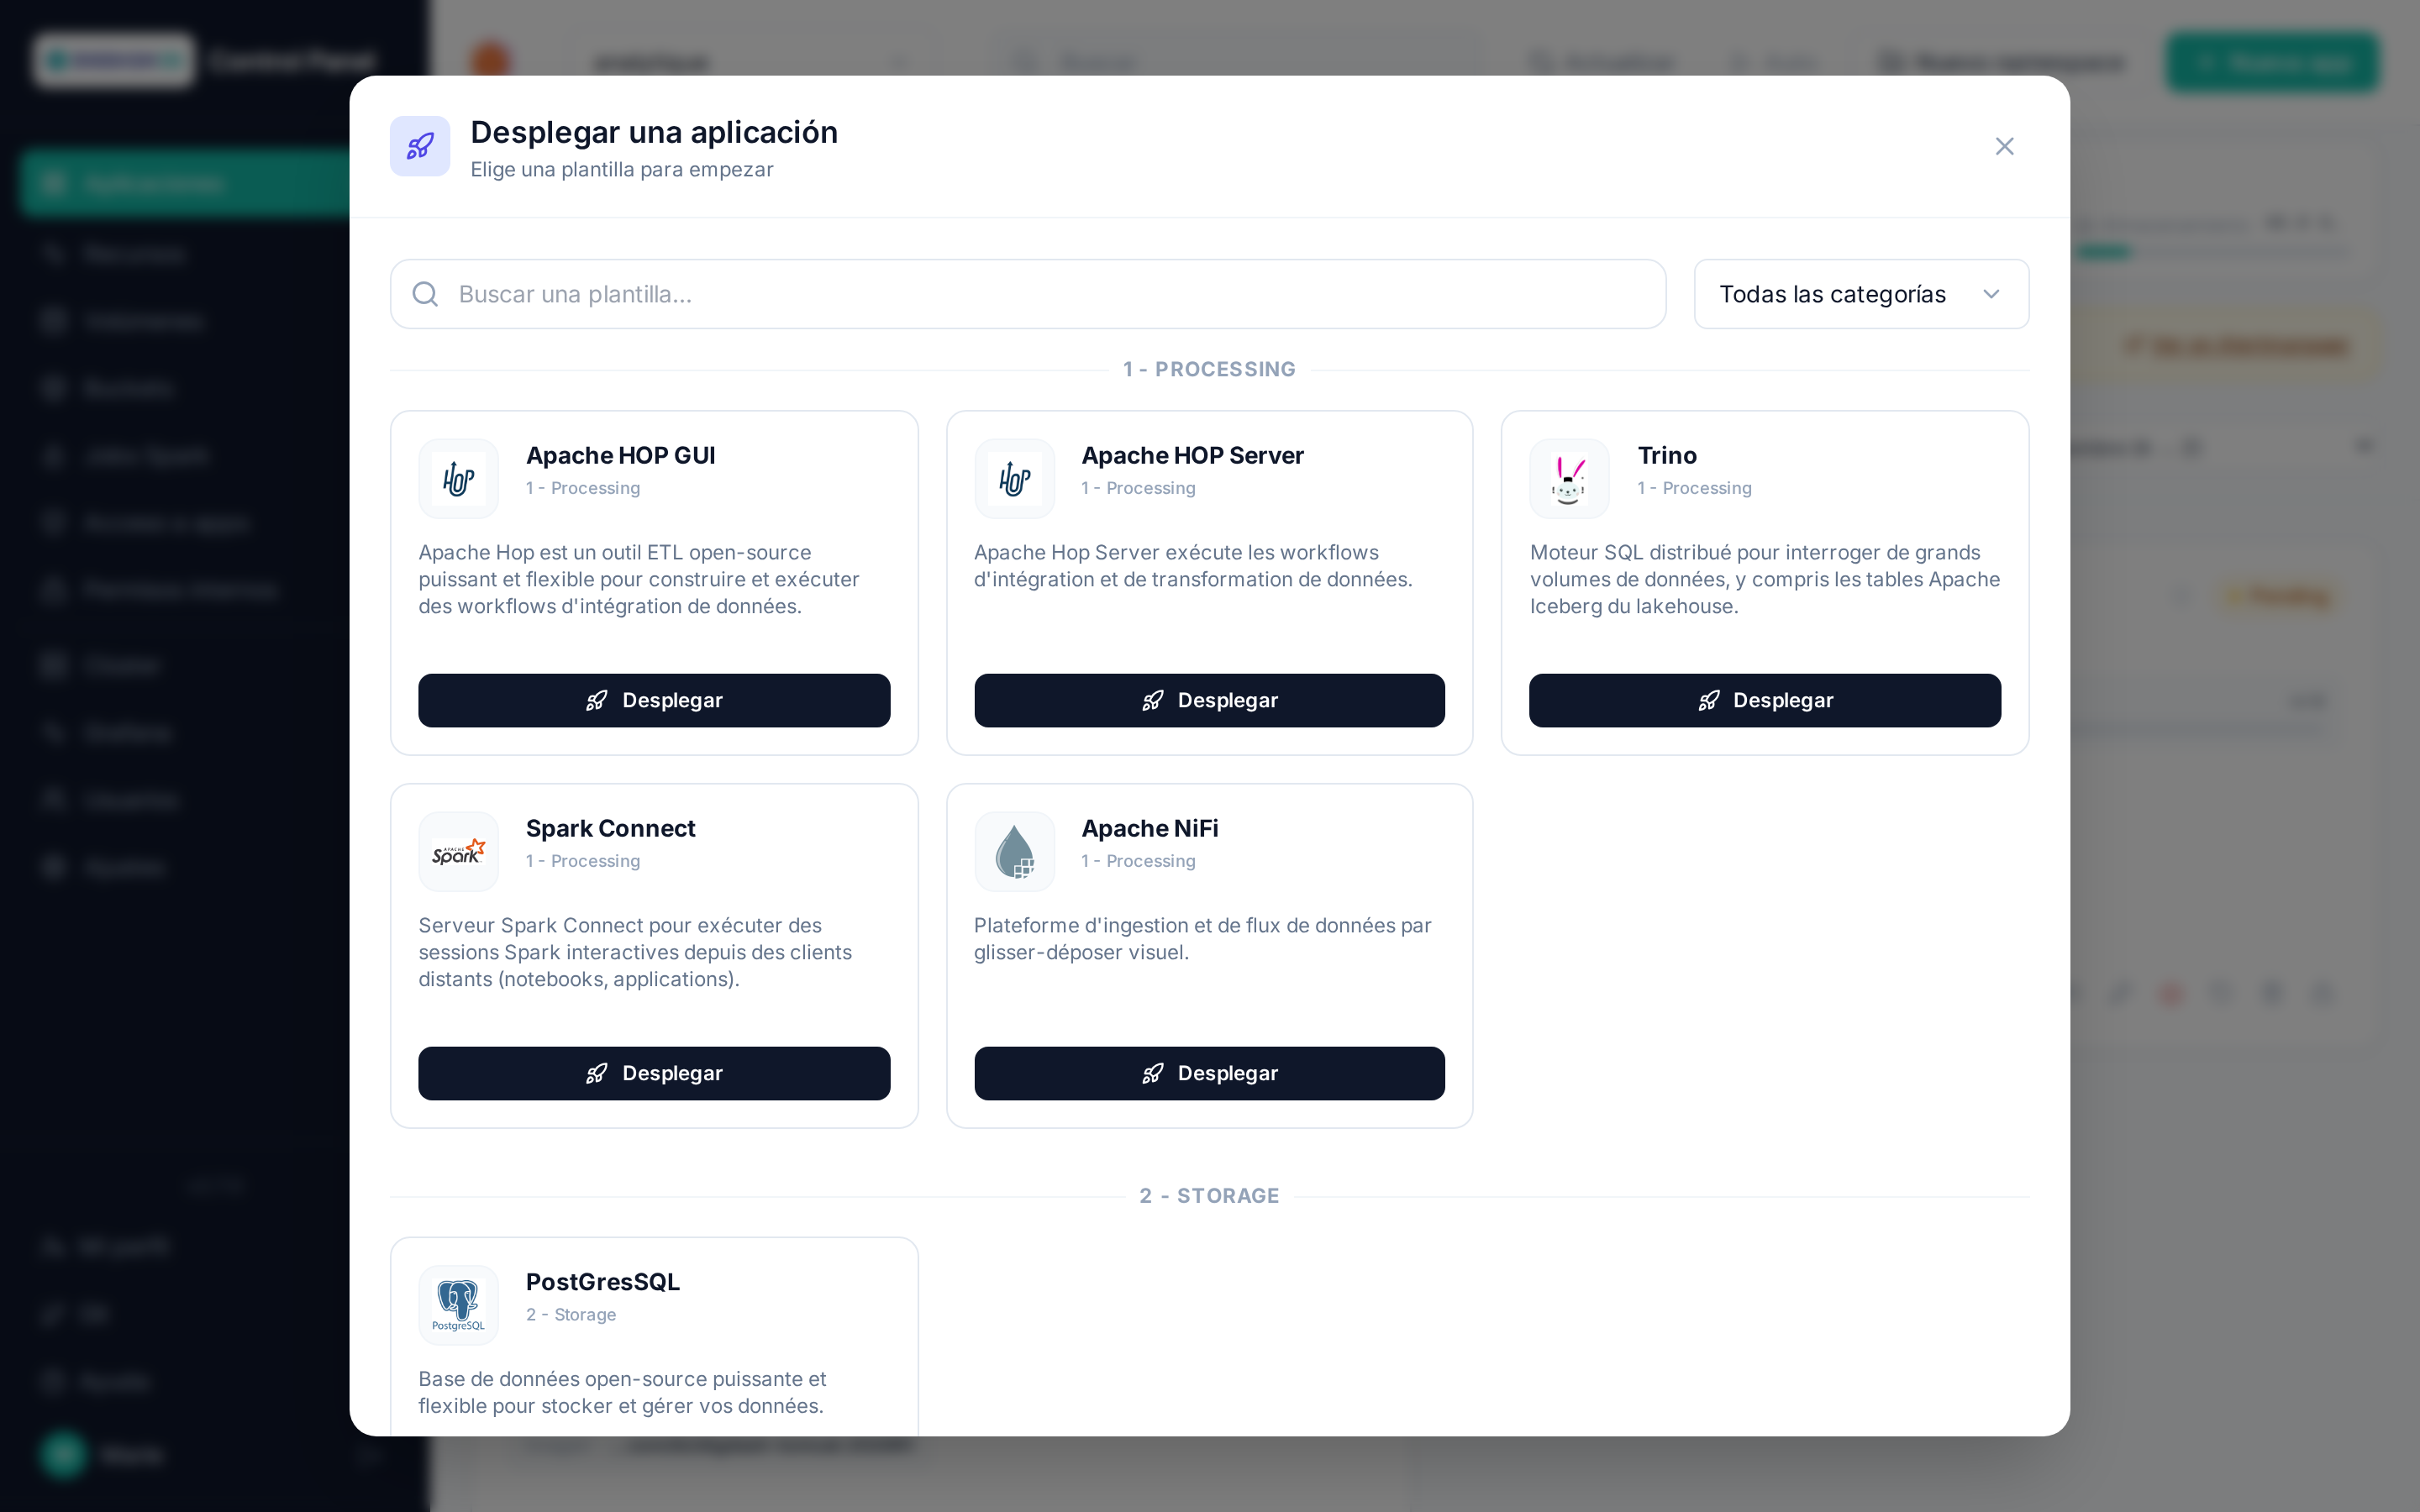
Seis plantillas del catálogo forman juntas un lakehouse sobre los buckets S3 de la plataforma: un catálogo de tablas Apache Iceberg (implementado por Apache Polaris), el motor SQL distribuido Trino, notebooks JupyterHub, un servidor Spark Connect, un servidor de tracking MLflow y Apache NiFi para la ingesta. El catálogo se despliega primero, el resto en el orden deseado, en el mismo namespace.
flowchart LR
    B[(Bucket S3<br/>warehouse)]
    P[Apache Iceberg<br/>catálogo Polaris]
    T[Trino]
    J[JupyterHub]
    S[Spark Connect]
    M[MLflow]
    N[Apache NiFi]
    T -- metadatos --> P
    J -- metadatos --> P
    P -- archivos de metadatos --> B
    T -- datos Parquet --> B
    J -- datos --> B
    J -- Spark Connect --> S
    S -- metadatos --> P
    S -- datos --> B
    J -- runs --> M
    M -- artefactos --> B
    N -- ingesta --> B
Apache Iceberg (catálogo Polaris)
La plantilla Apache Iceberg (categoría Gobernanza) despliega un catálogo Iceberg REST — Apache Polaris — respaldado por una base PostgreSQL (CloudNativePG) creada con él.
| Campo | Función |
|---|---|
| Bucket S3 del warehouse (pestaña Almacenamiento, obligatorio) | Bucket que contendrá tablas y metadatos. Elegir un bucket del namespace rellena automáticamente endpoint, región y claves de acceso. |
| Nombre del catálogo Iceberg | lakehouse por defecto: es el warehouse al que se refieren Trino, Spark o PyIceberg. Fijado en la creación. |
| Realm Polaris | POLARIS por defecto, un realm por instancia. Fijado en la creación. |
| Límite de memoria / CPU, Tamaño del almacenamiento PostgreSQL | Capacidad del servidor y de su base. |
Al desplegar se ejecutan automáticamente dos tareas: la inicialización del realm (credenciales del principal root) y la creación del catálogo en el bucket, con los permisos necesarios. La tarjeta pasa a Running antes de que terminen — cuente uno o dos minutos más antes de que el catálogo sea utilizable.
Credenciales del catálogo
Los motores se autentican ante el catálogo con el principal root, guardado en el secreto <nombre>-root-principal del namespace (claves clientId, clientSecret, catalogUri, catalogName) — véase Secretos. El catálogo no distribuye credenciales S3 temporales (sin STS en el almacenamiento de objetos de la plataforma): cada motor usa sus propias claves del bucket, de ahí los campos S3 repetidos en las plantillas Trino y JupyterHub.
La API REST se expone en https://<nombre>-<namespace>.<dominio>/api/catalog (solo llamadas autenticadas — sin interfaz web).
Trino
La plantilla Trino (categoría Procesamiento) despliega un coordinador y workers Trino con un catálogo lakehouse preconectado a la instancia Apache Iceberg elegida.
| Campo | Función |
|---|---|
| Catálogo Apache Iceberg (Polaris) (obligatorio) | Instancia Apache Iceberg del mismo namespace. Fijado en la creación. |
| Catálogo Iceberg (warehouse) | Nombre del catálogo en Polaris (lakehouse por defecto). |
| Bucket S3 del warehouse (pestaña Almacenamiento) | El mismo bucket que el del catálogo: selecciónelo para rellenar endpoint, región y claves. |
| Número de workers, Memoria del coordinador / por worker | Capacidad. La memoria de un pod debe mantenerse ≥ 3 Gi (heap JVM fijado en 1,4 GB, más el fuera de heap). |
El inicio de sesión usa su cuenta de la plataforma (OpenID Connect): la interfaz web https://<nombre>-<namespace>.<dominio>/ui/ y los clientes SQL (trino --server https://… --external-authentication, JDBC con externalAuthentication=true). Como con Apache Hop, el acceso se concede desde Acceso a los usuarios o grupos deseados — véase Acceso y permisos.
Ejemplo, una vez conectado:
CREATE SCHEMA lakehouse.ventas;
CREATE TABLE lakehouse.ventas.pedidos AS SELECT 1 AS id, 'test' AS etiqueta;
SELECT * FROM lakehouse.ventas.pedidos;
Los archivos Parquet y los metadatos Iceberg aparecen en el bucket bajo <esquema>/<tabla>-<uuid>/.
JupyterHub
La plantilla JupyterHub (categoría Ciencia de datos) da a cada usuario su propio servidor JupyterLab, con un volumen persistente personal e inicio de sesión mediante la cuenta de la plataforma. Quien despliega la instancia es su administrador (/hub/admin).
| Campo | Función |
|---|---|
| Imagen de los notebooks / Versión | Imagen Jupyter de los servidores de usuario (ds/jupyter-datastack por defecto: JupyterLab + clientes Spark Connect, PyIceberg, Trino, MLflow). |
| CPU / Memoria máx. por usuario, Almacenamiento por usuario | Capacidad de cada servidor; el volumen se crea en el primer arranque. |
| Catálogo Apache Iceberg, Trino, Spark Connect, MLflow (pestaña Lakehouse, opcionales) | Instancias del mismo namespace que se preconectan en los notebooks (variables de entorno). |
| Bucket S3 (pestaña Almacenamiento, opcional) | Claves S3 expuestas a los notebooks (AWS_*). |
Variables disponibles en cada notebook cuando el servicio correspondiente está configurado:
| Variable | Contenido |
|---|---|
POLARIS_URI, POLARIS_WAREHOUSE, POLARIS_CREDENTIAL, POLARIS_SCOPE |
Catálogo Iceberg REST y credenciales clientId:clientSecret |
TRINO_HOST |
Coordinador Trino (nombre:8080, acceso interno al namespace) |
SPARK_REMOTE, MLFLOW_TRACKING_URI |
Spark Connect y MLflow (si están desplegados) |
AWS_ENDPOINT_URL, AWS_REGION, AWS_ACCESS_KEY_ID, AWS_SECRET_ACCESS_KEY |
Acceso S3 al warehouse |
Ejemplo con PyIceberg:
import os
from pyiceberg.catalog.rest import RestCatalog

catalog = RestCatalog(
    "lakehouse",
    uri=os.environ["POLARIS_URI"],
    warehouse=os.environ["POLARIS_WAREHOUSE"],
    credential=os.environ["POLARIS_CREDENTIAL"],
    scope=os.environ["POLARIS_SCOPE"],
    **{"s3.endpoint": os.environ["AWS_ENDPOINT_URL"],
       "s3.access-key-id": os.environ["AWS_ACCESS_KEY_ID"],
       "s3.secret-access-key": os.environ["AWS_SECRET_ACCESS_KEY"]},
)
print(catalog.list_namespaces())
Una instancia JupyterHub por namespace
El chart solo admite un JupyterHub por namespace; un segundo despliegue se rechaza con un mensaje explícito. Los servidores de usuario inactivos durante una hora se detienen automáticamente (el volumen personal se conserva).
Spark Connect
La plantilla Spark Connect (categoría Procesamiento) despliega un servidor Apache Spark en modo local (ejecutores dentro del pod) expuesto mediante el protocolo Spark Connect: los notebooks y clientes PySpark del namespace comparten una única instalación Spark, ya configurada sobre el catálogo Apache Iceberg elegido. Sin ruta pública (protocolo gRPC interno al namespace).
| Campo | Función |
|---|---|
| Catálogo Apache Iceberg (Polaris) (obligatorio) | Instancia del mismo namespace; catálogo Spark por defecto lakehouse. Fijado en la creación. |
| Bucket S3 del warehouse (pestaña Almacenamiento) | El mismo bucket que el del catálogo: selecciónelo para rellenar endpoint, región y claves. |
| Núcleos Spark, Memoria Spark (driver), Límite de memoria del pod | Capacidad (local[N]); mantenga ~1 Gi de margen entre la memoria Spark y el límite del pod. |
| Exigir un token de conexión | Token compartido (spark.connect.authenticate.token), guardado en el secreto <nombre>-platform. Desactivado por defecto. |
Desde un notebook JupyterHub asociado (SPARK_REMOTE prerrellenado) o cualquier cliente pyspark-client de la misma versión menor que el servidor:
from pyspark.sql import SparkSession
spark = SparkSession.builder.remote(os.environ["SPARK_REMOTE"]).getOrCreate()
spark.sql("CREATE TABLE lakehouse.demo.t (x INT) USING iceberg")
spark.sql("SELECT * FROM lakehouse.demo.t").show()
MLflow
La plantilla MLflow (categoría Ciencia de datos) despliega un servidor de tracking MLflow: experimentos, runs y registro de modelos en una base PostgreSQL (CloudNativePG) creada con él, artefactos servidos por el servidor en un bucket S3. El acceso web está protegido por el inicio de sesión de la plataforma (el servidor MLflow no tiene autenticación propia): como con Apache Hop, los usuarios y grupos autorizados se gestionan desde Acceso.
| Campo | Función |
|---|---|
| Bucket S3 de los artefactos (pestaña Almacenamiento, obligatorio) | Bucket (y prefijo, mlflow por defecto) de los artefactos. Fijado en la creación. |
| Procesos del servidor | Número de workers del servidor. |
| Límite de memoria / CPU, Tamaño del almacenamiento PostgreSQL | Capacidad. |
Desde un notebook asociado (MLFLOW_TRACKING_URI prerrellenado, acceso interno sin login): import mlflow; mlflow.set_tracking_uri(os.environ["MLFLOW_TRACKING_URI"]); mlflow.log_metric("accuracy", 0.99). Los artefactos pasan por el servidor: los notebooks no necesitan claves S3.
Apache NiFi
La plantilla Apache NiFi (categoría Procesamiento) despliega un nodo NiFi 2 (sin ZooKeeper) con inicio de sesión mediante la cuenta de la plataforma: quien despliega la instancia es el administrador inicial y autoriza las demás cuentas desde la interfaz NiFi (menú Users / Policies). El flow y los repositorios (FlowFiles, contenido, procedencia, estado) están en un volumen persistente.
| Campo | Función |
|---|---|
| Heap JVM, Límite de memoria / CPU | Capacidad; mantenga ~1 Gi de margen entre el heap y el límite. |
| Tamaño del volumen | Repositorios y flow. Fijado en la creación. |
TLS de extremo a extremo
NiFi 2 solo escucha en HTTPS: se genera un certificado interno al desplegar, verificado por la pasarela de la plataforma. El primer arranque tarda de 1 a 3 minutos (carga de extensiones).
Jobs Spark batch (Spark Operator)
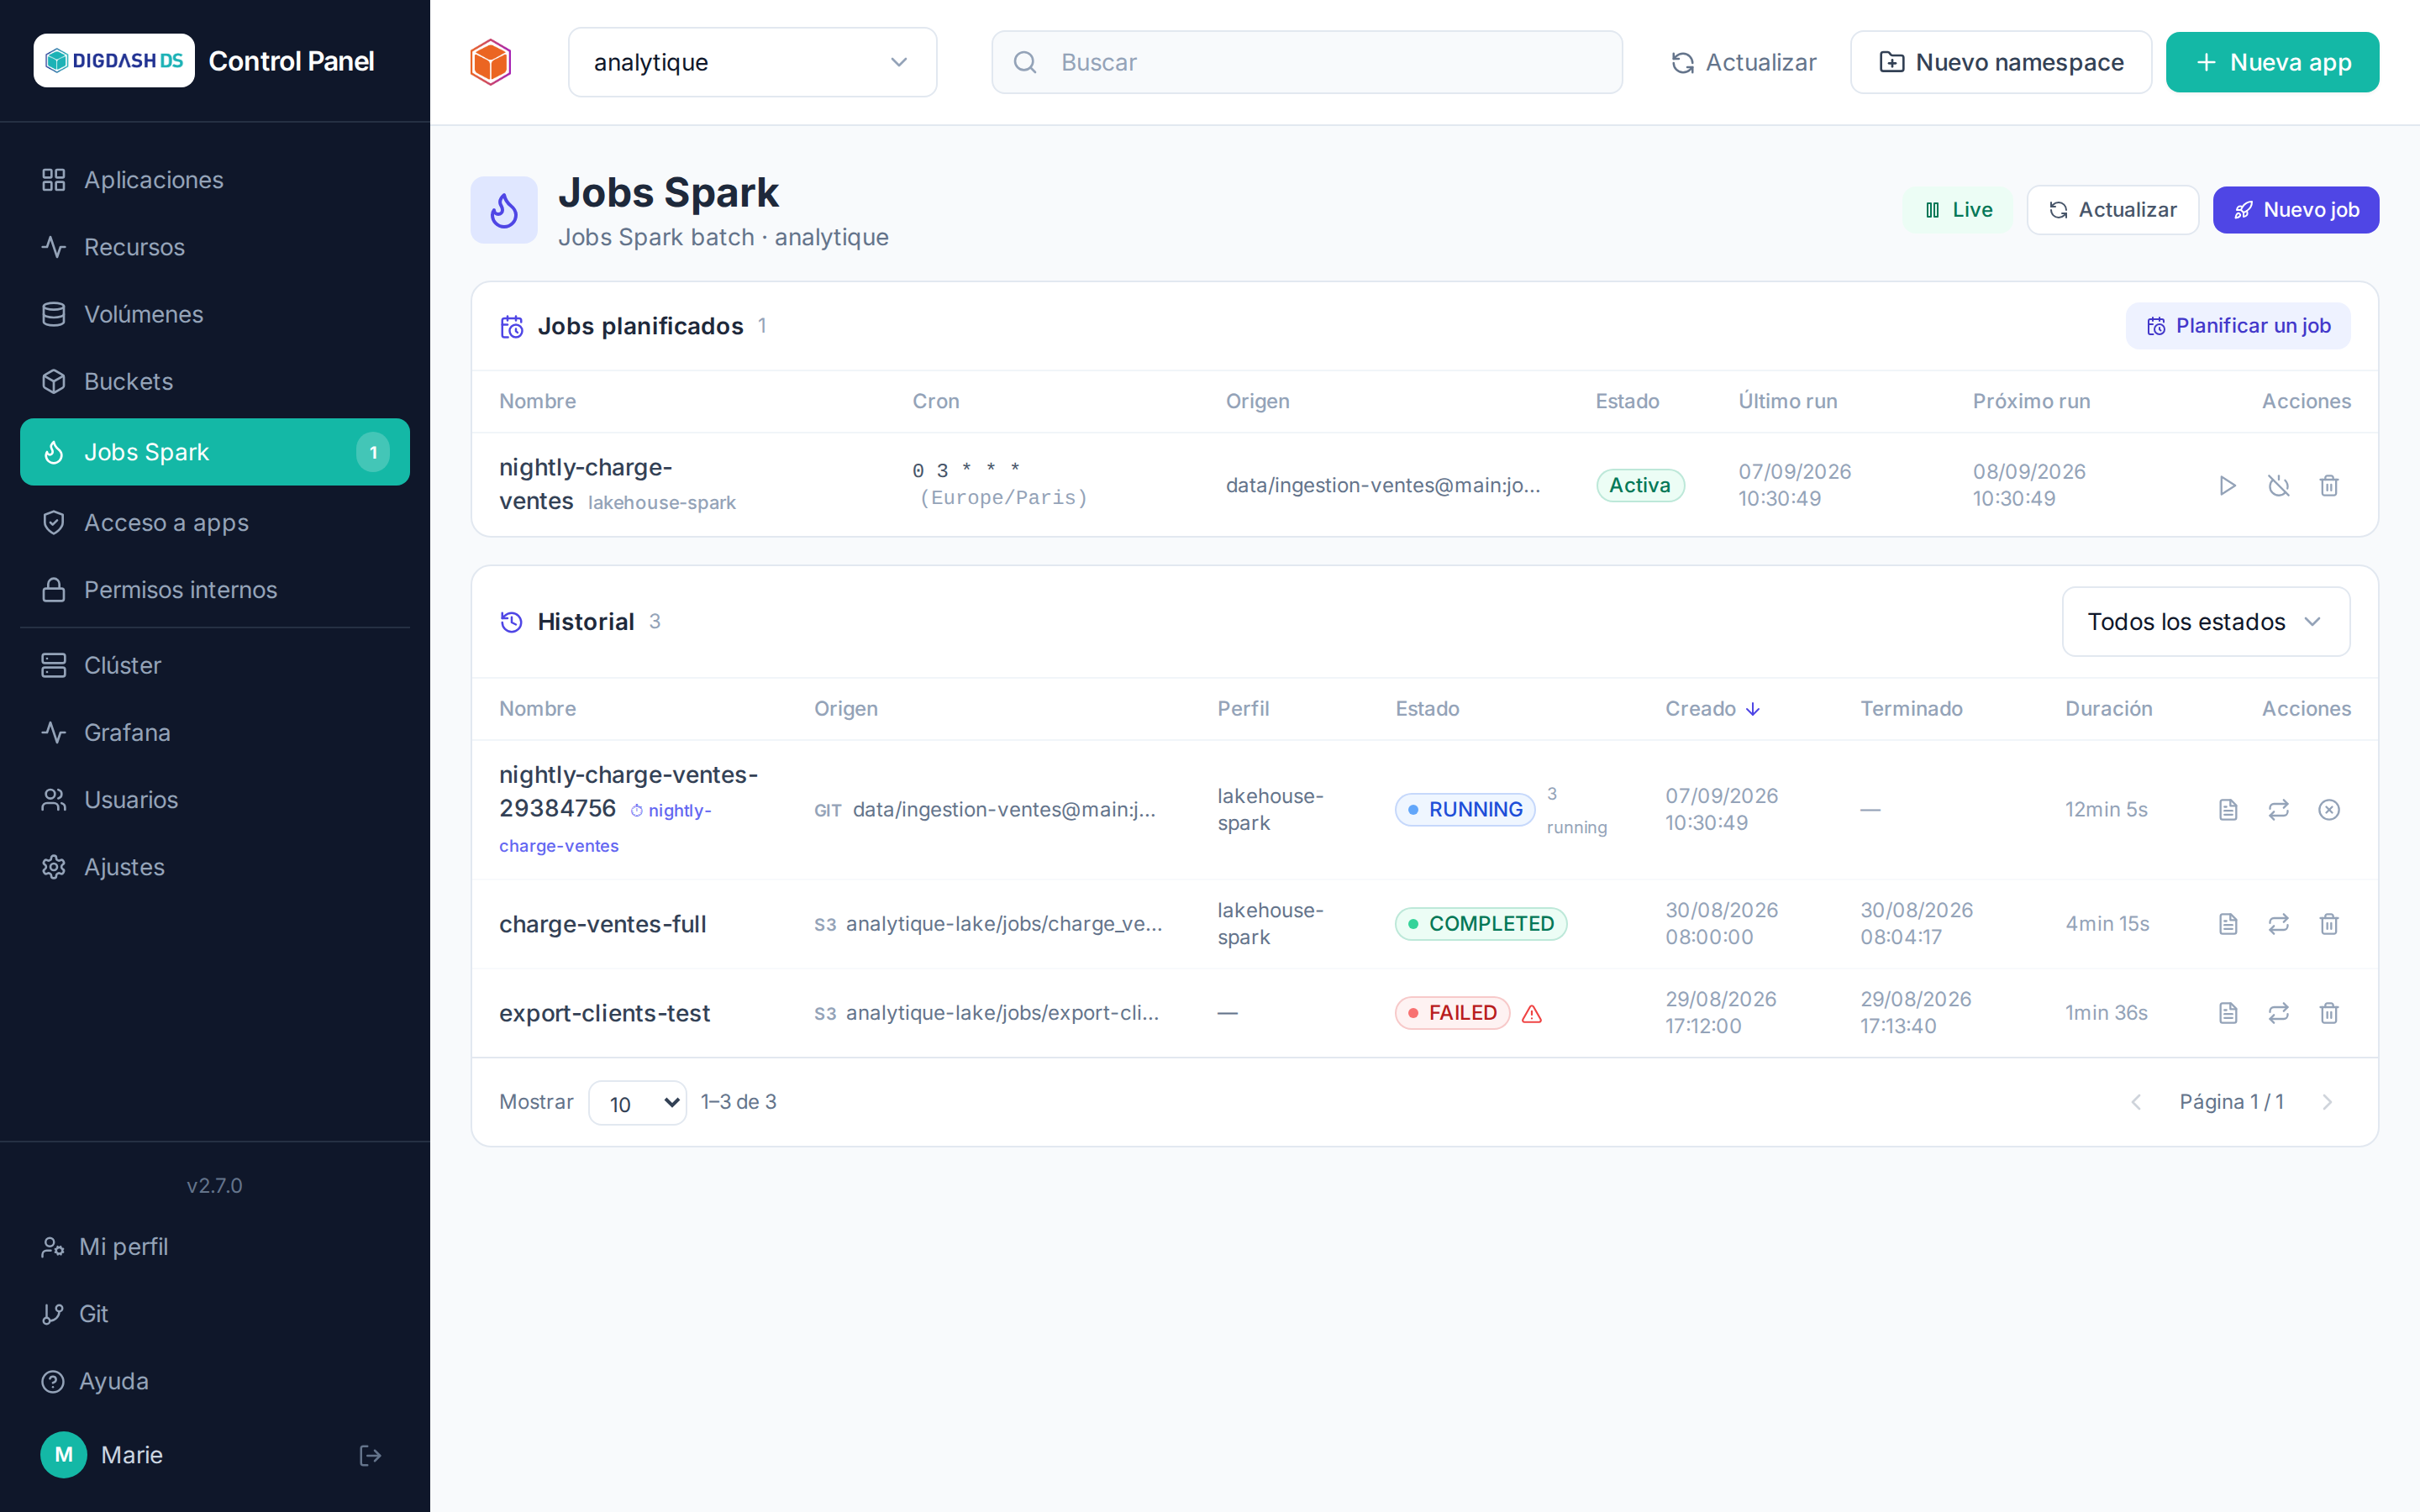
Para los tratamientos Spark autónomos o planificados (fuera de una sesión interactiva Spark Connect), la página Jobs Spark de la barra lateral lanza y sigue jobs batch en el namespace actual, mediante el Kubeflow Spark Operator instalado en la plataforma: cada job es un recurso Kubernetes SparkApplication del namespace (o ScheduledSparkApplication para una planificación cron); el operador lanza el driver y luego los ejecutores como pods, y limpia al final. El botón Jobs Spark de una tarjeta Spark Connect abre la misma página, filtrada en esa instancia como perfil.
Lanzar un job
Nuevo job abre el formulario:
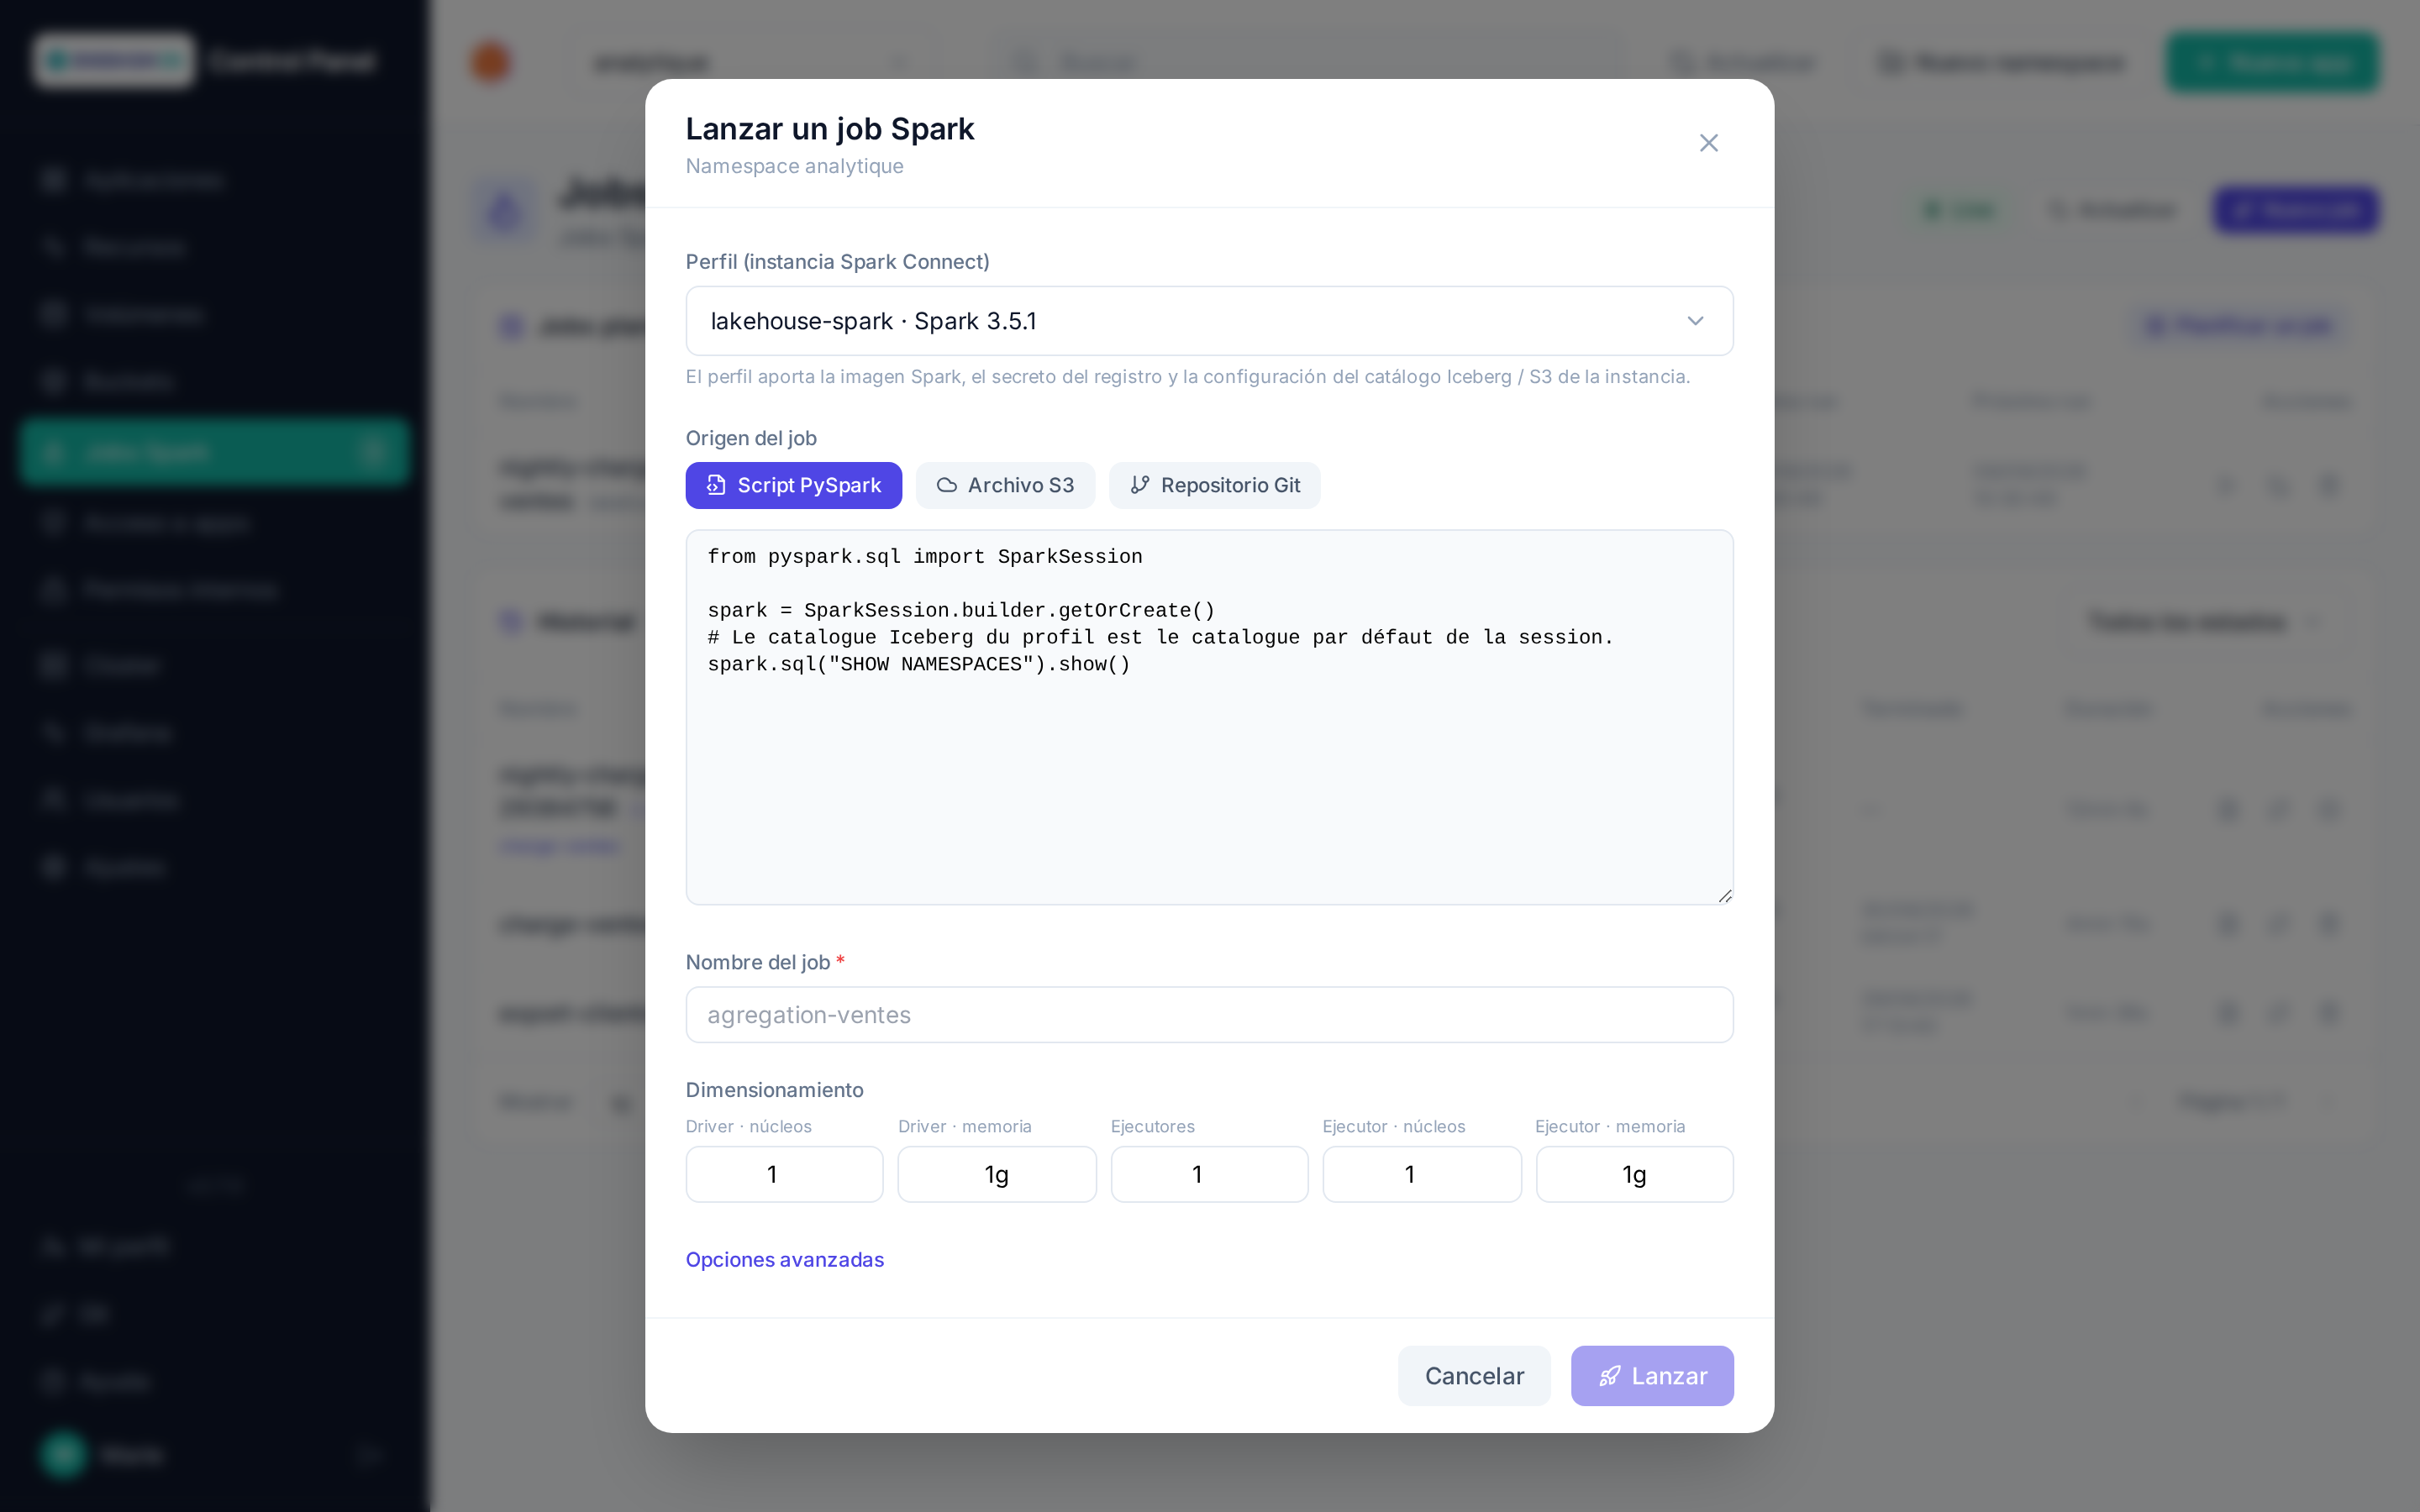
| Campo | Función |
|---|---|
| Perfil | Una instancia Spark Connect del namespace: el job reutiliza su imagen Spark (jars Iceberg incluidos), su secreto de registro y la configuración de su catálogo Apache Iceberg / S3 (catálogo por defecto de la sesión). Sin perfil, indique una imagen Spark explícita (y su secreto de registro). |
| Origen | El archivo principal del job: un script PySpark escrito directamente, un archivo S3 (bucket del namespace + ruta del objeto; endpoint y claves rellenados por el selector de bucket), o un archivo de un repositorio Git Forgejo (instancia, repositorio, rama, ruta — clonado con su token personal, véase Git). Una clase principal (opciones avanzadas) cambia a un job Scala/Java sobre un .jar. |
| Nombre | Identificador Kubernetes del job (minúsculas, cifras, guiones) — propuesto a partir del archivo. |
| Dimensionamiento | Núcleos y memoria del driver, número de ejecutores, núcleos y memoria por ejecutor. |
| Opciones avanzadas | Argumentos, propiedades Spark adicionales (spark.*), retención del recurso tras el fin — en horas, 168 (7 días) por defecto. |
El driver se ejecuta con la cuenta de servicio spark del namespace (límites de CPU/memoria en cada contenedor, como exige la cuota del namespace); los orígenes S3 y Git los recupera un initContainer (aws s3 cp / git clone) en un volumen montado en /opt/job, y el script escrito mediante un ConfigMap sparkjob-<nombre>. Las credenciales (catálogo, S3, Git) permanecen en Secretos del namespace, nunca en el formulario anotado en el recurso.
Seguimiento
El historial lista los jobs del namespace con su estado (SUBMITTED, RUNNING, COMPLETED, FAILED…), su origen, su perfil y su duración; se refresca solo mientras un job está activo. Para cada job:
- Detalle y logs: pods driver/ejecutores y últimas líneas del driver, en directo mientras el job se ejecuta;
- Relanzar tal cual: nuevo recurso
<nombre>-<sufijo>a partir del formulario original (perfil resuelto de nuevo, es decir imagen y configuración al día); Relanzar con cambios reabre el formulario prerrellenado; - Cancelar (job activo) detiene driver y ejecutores; Eliminar (job terminado) retira el recurso y sus logs.
Se aplican los roles habituales: lectura para un viewer, lanzamiento/cancelación/eliminación para un operator, planificación para un admin del namespace.
Jobs planificados
Planificar un job reutiliza el formulario de lanzamiento con una expresión cron (5 campos), una zona horaria, una política de concurrencia (prohibir solapamientos, permitir, reemplazar) y el número de runs conservados. Cada planificación puede lanzarse ahora, suspenderse y reactivarse, o eliminarse; sus runs aparecen en el historial con el marcador ⏱ del nombre de la planificación.
Sin la interfaz
Los recursos siguen siendo manipulables con kubectl -n <namespace> get sparkapplications: un job creado a mano aparece en el historial (cancelación/eliminación posibles, pero sin relanzamiento al no existir formulario original). En un clúster sin acceso a Docker Hub, las imágenes de los initContainers se sobrescriben en Parámetros del clúster: SPARK_JOB_GIT_IMAGE (por defecto alpine/git) y SPARK_JOB_S3_IMAGE (por defecto amazon/aws-cli).
Namespaces creados antes del operador
La cuenta de servicio spark se crea con cada namespace y se comprueba en cada lanzamiento; para los namespaces anteriores a la instalación del operador, la instalación también la crea (o python manage.py ensure_spark_rbac en ControlPanel).
Eliminación
Eliminar una instancia Trino, JupyterHub, MLflow o NiFi también retira su cliente OpenID de la plataforma; eliminar Spark Connect no afecta a nada más. Eliminar el catálogo Apache Iceberg elimina su base PostgreSQL y sus secretos, pero no los archivos del bucket: las tablas siguen siendo legibles por un nuevo catálogo que apunte a la misma ubicación, o pueden limpiarse desde la página Buckets.