Cluster
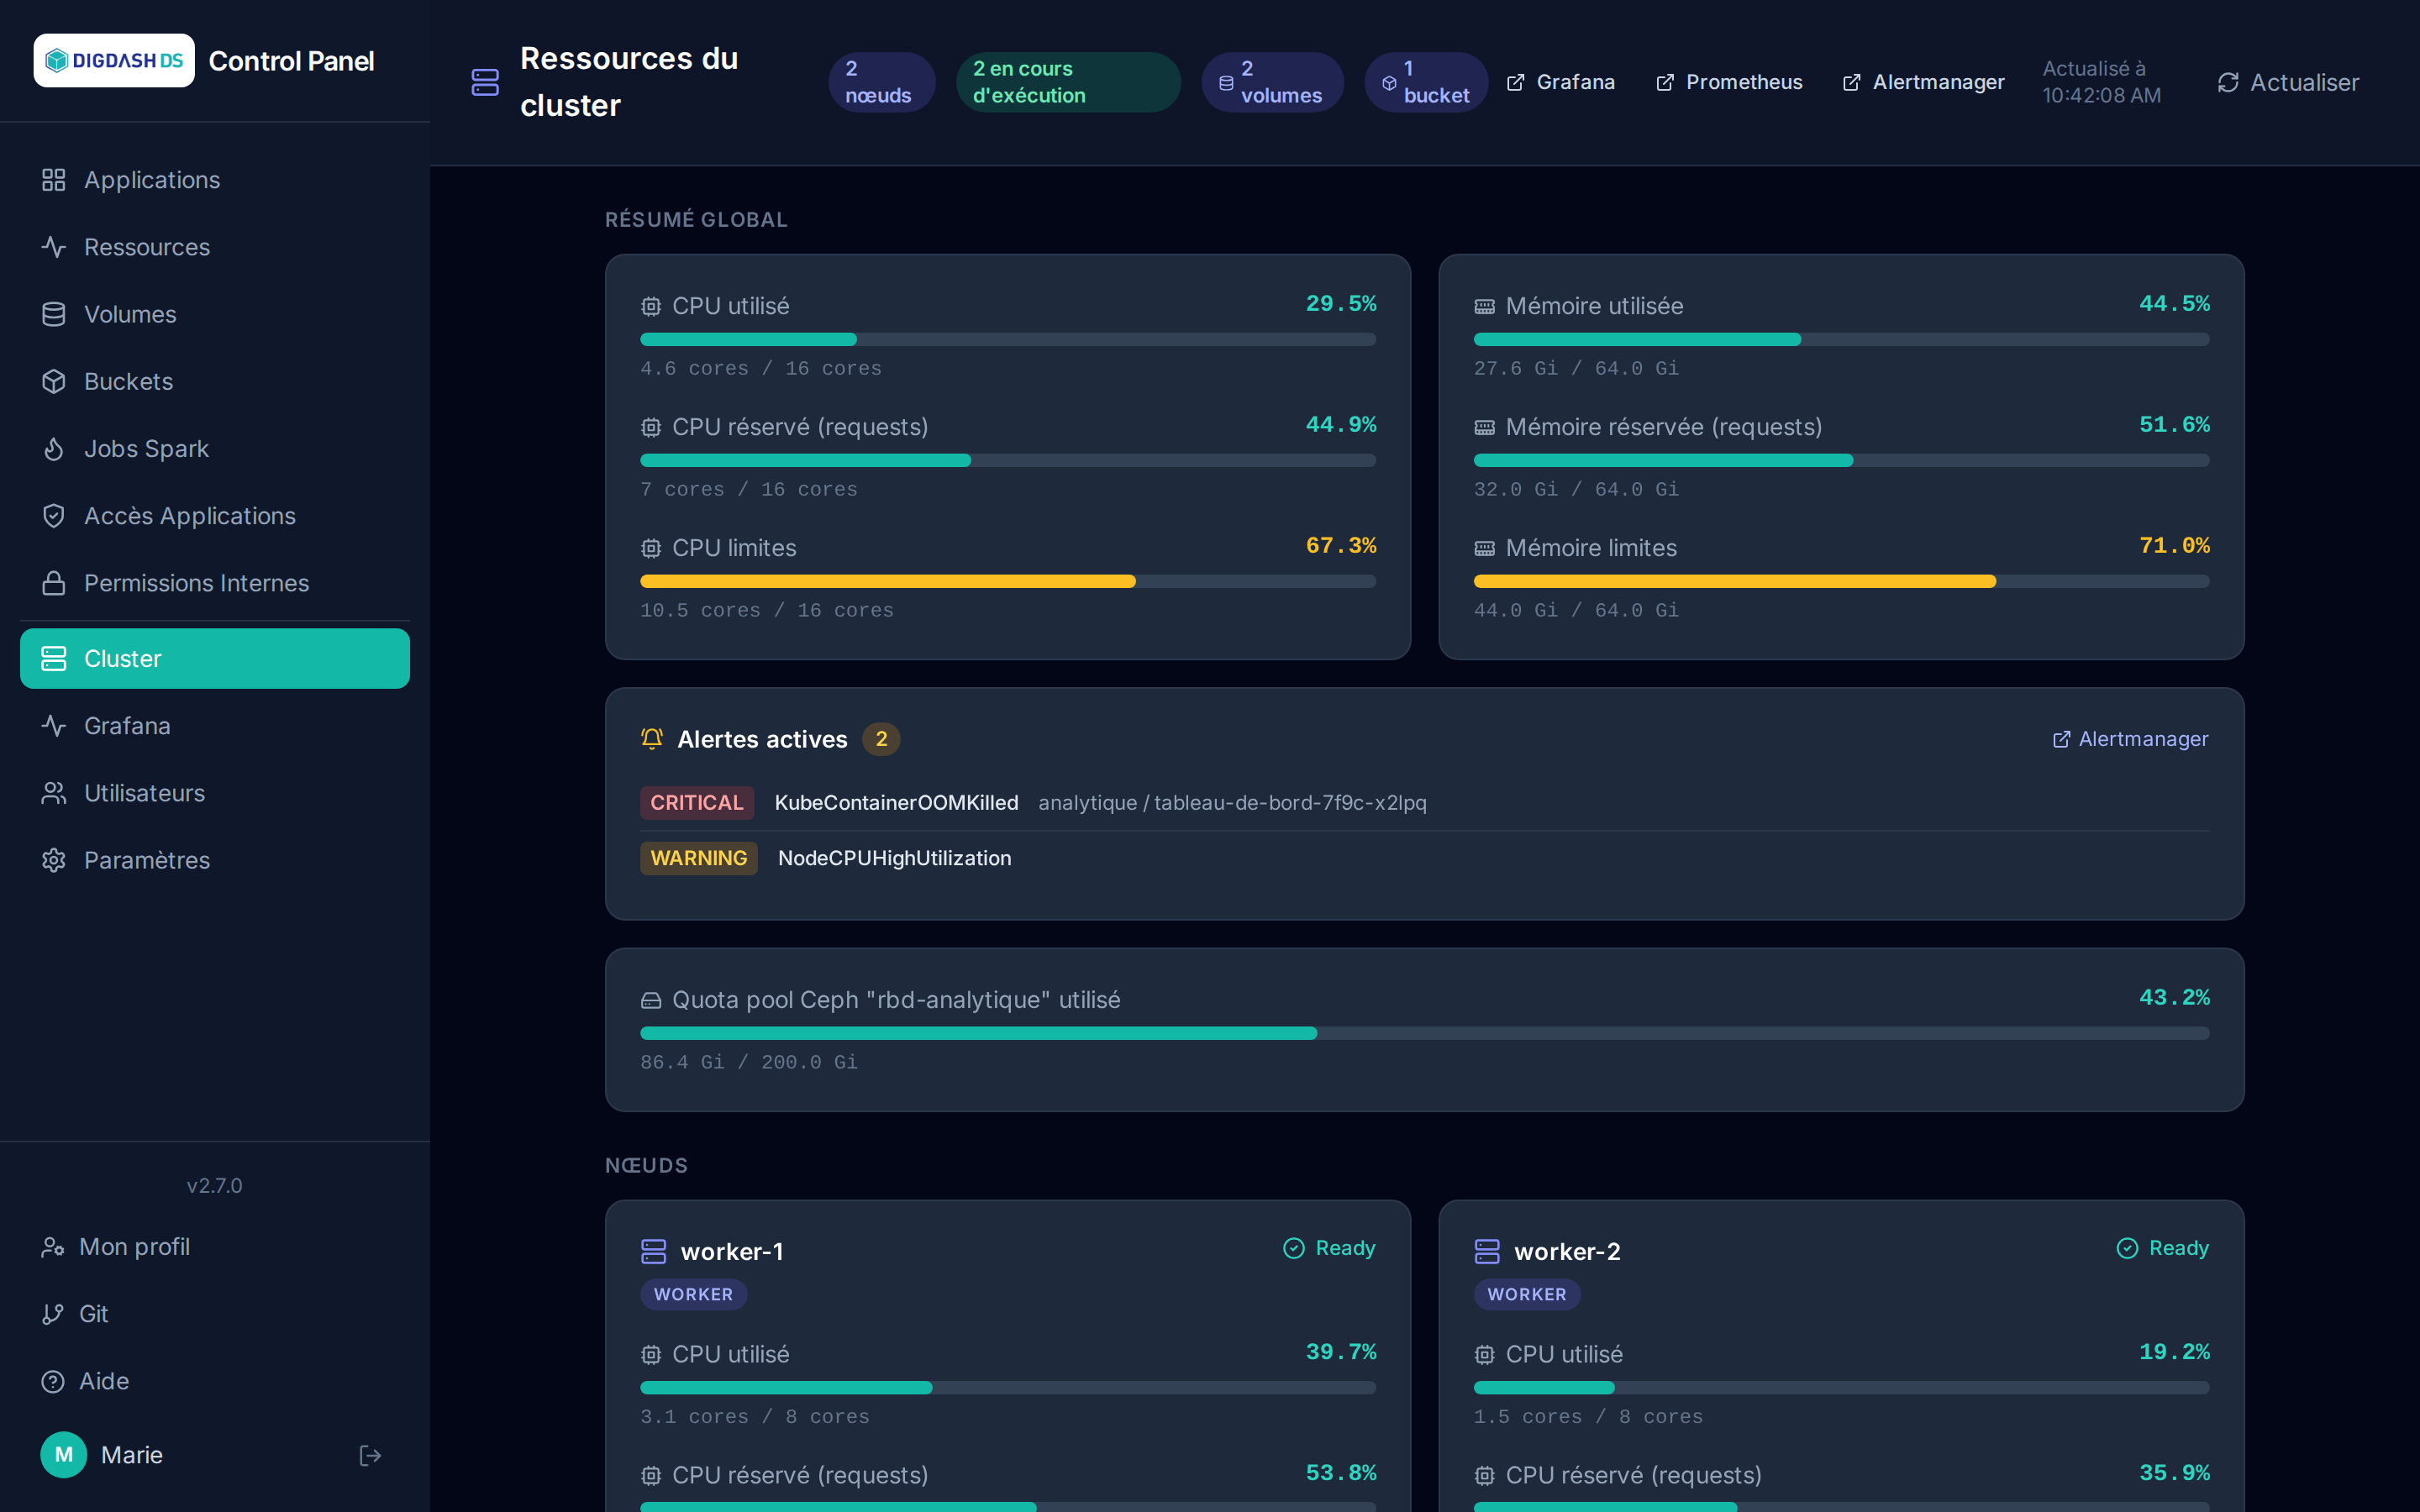
La page Cluster (réservée aux administrateurs de plateforme) donne une vue d'ensemble, en direct, des ressources Kubernetes de toute la plateforme — tous namespaces confondus. Elle se rafraîchit automatiquement toutes les 30 secondes, ou immédiatement via Actualiser.
L'en-tête affiche quatre indicateurs rapides : le nombre de nœuds, le nombre de pods en cours d'exécution, ainsi que le nombre total de volumes et de buckets de la plateforme, tous namespaces confondus.
Résumé global
Trois indicateurs par ressource (CPU et mémoire), rapportés à la capacité totale du cluster :
| Indicateur | Signification |
|---|---|
| Utilisé | Consommation réelle mesurée par le serveur de métriques |
| Réservé (requests) | Somme des quantités demandées par tous les pods — ce que Kubernetes garantit |
| Limites | Somme des plafonds configurés — peut dépasser la capacité réelle (sur-allocation), à surveiller |
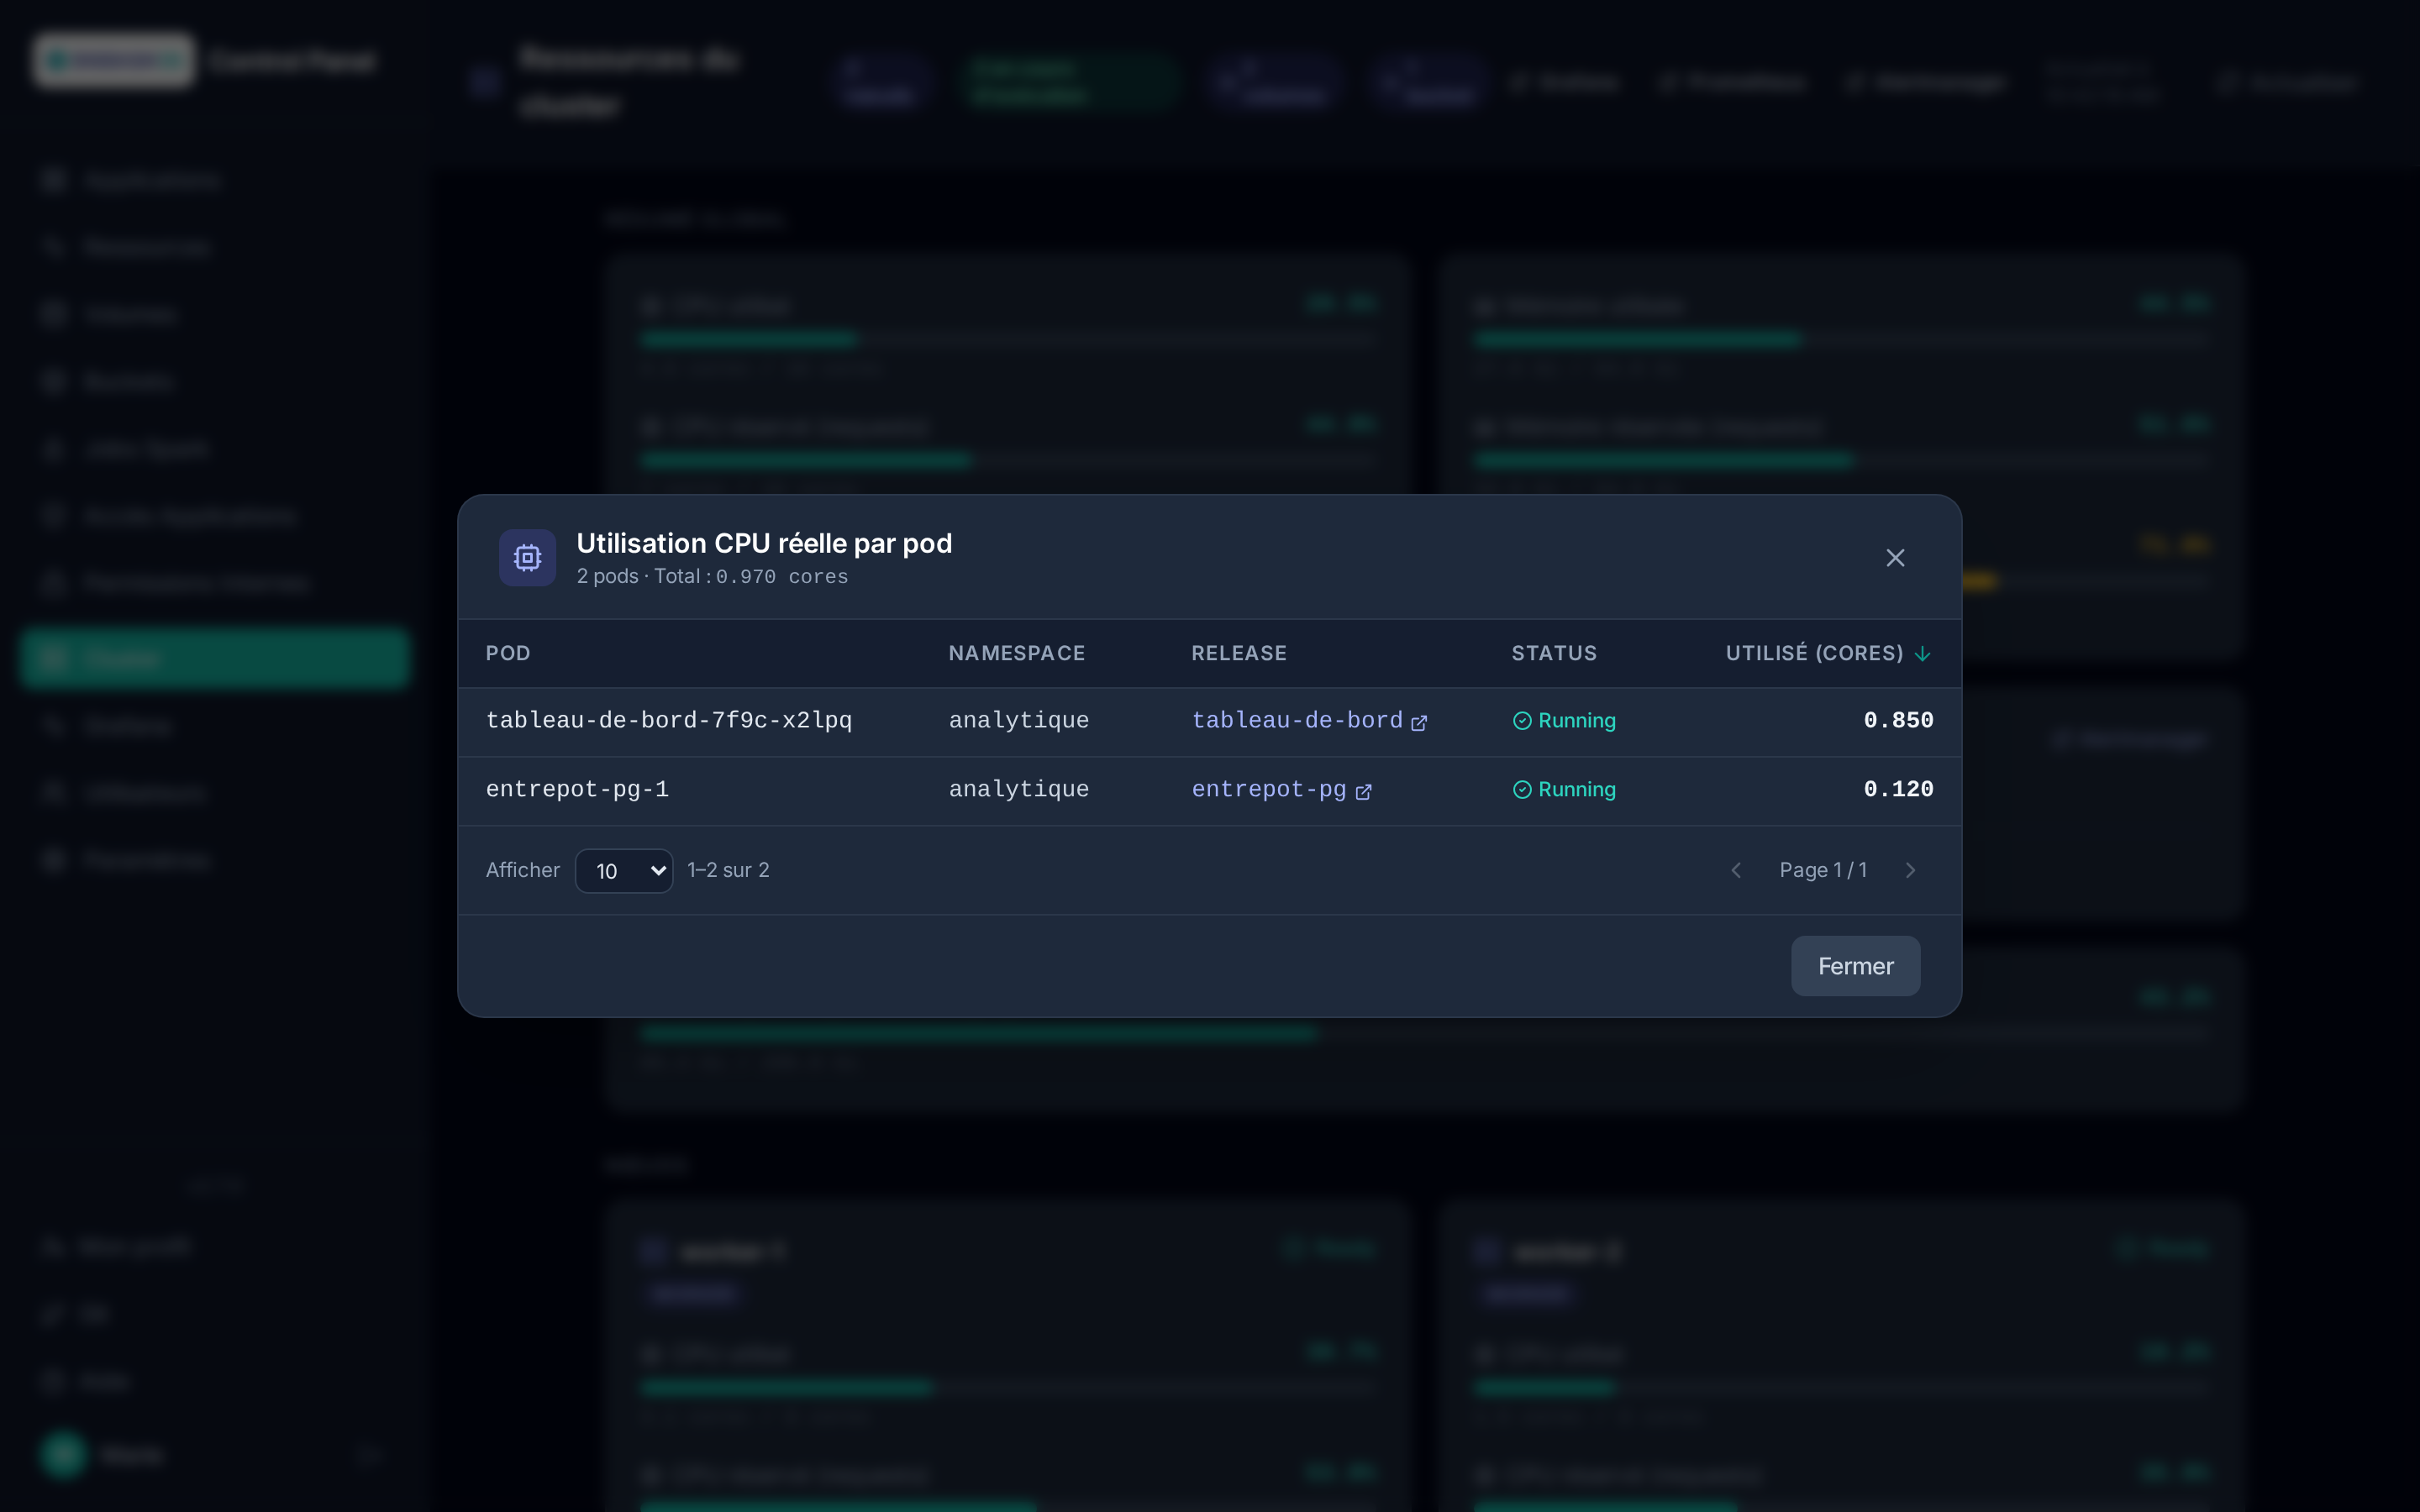
Cliquer sur le libellé d'un indicateur ouvre la répartition par pod : la liste de tous les pods du cluster triée par consommation, avec un lien direct vers l'application correspondante lorsque le pod appartient à une release gérée par le Control Panel.
Stockage
Une carte Stockage Ceph complète le résumé global lorsque l'information est disponible. Elle affiche, selon ce qui a pu être déterminé :
- le quota du pool Ceph RBD applicatif et son occupation, si ce pool a un quota fixé ;
- à défaut, l'occupation du pool rapportée à la capacité totale du cluster Ceph, si le pool n'a pas de quota ;
- en dernier repli, la capacité globale du cluster Ceph (Rook), si le pool applicatif n'a pas pu être déterminé.
La carte est absente si aucune de ces informations n'est disponible (CLI ceph injoignable, par exemple).
Supervision
Lorsque la stack de supervision de la plateforme (Prometheus, Grafana, Alertmanager) est installée, l'en-tête de la page propose trois liens externes Grafana, Prometheus et Alertmanager (authentification via le compte plateforme habituel), et une carte Alertes actives liste les alertes Prometheus en cours (firing), les plus sévères en premier, avec leur namespace et le pod concerné.
La même stack alimente ailleurs dans le Control Panel :
- la colonne Utilisé de la page Volumes ;
- le lien Métriques des cartes d'application (dashboard Grafana du pod ou du namespace) — voir Applications ;
- le bandeau n alertes actives au-dessus du tableau de bord d'un namespace ;
- le lien Grafana de la barre latérale.
Si Prometheus est injoignable depuis le Control Panel, les liens restent affichés mais la carte l'indique et les valeurs dérivées (alertes, consommation des volumes) sont marquées indisponibles (n/d). Les URL publiques (GRAFANA_URL, PROMETHEUS_PUBLIC_URL, ALERTMANAGER_URL) et l'adresse interne de Prometheus (PROMETHEUS_URL) peuvent être surchargées dans Paramètres cluster.
Nœuds
Chaque nœud du cluster est présenté avec son statut (Ready ou non), ses rôles, et les mêmes six jauges (CPU/mémoire × utilisé/réservé/limites) rapportées à sa propre capacité — utile pour repérer un nœud déséquilibré avant que le scheduler Kubernetes n'ait du mal à y placer de nouveaux pods.
Note
Ces jauges donnent une vue plateforme complète, y compris les charges qui ne sont pas des applications du catalogue (composants système, autres services du cluster). Pour le détail des ressources d'un seul namespace, voir la carte d'application correspondante sur le tableau de bord.