Jobs Spark batch (Spark Operator)
Fait partie du lakehouse (vue d'ensemble et schéma des interactions).
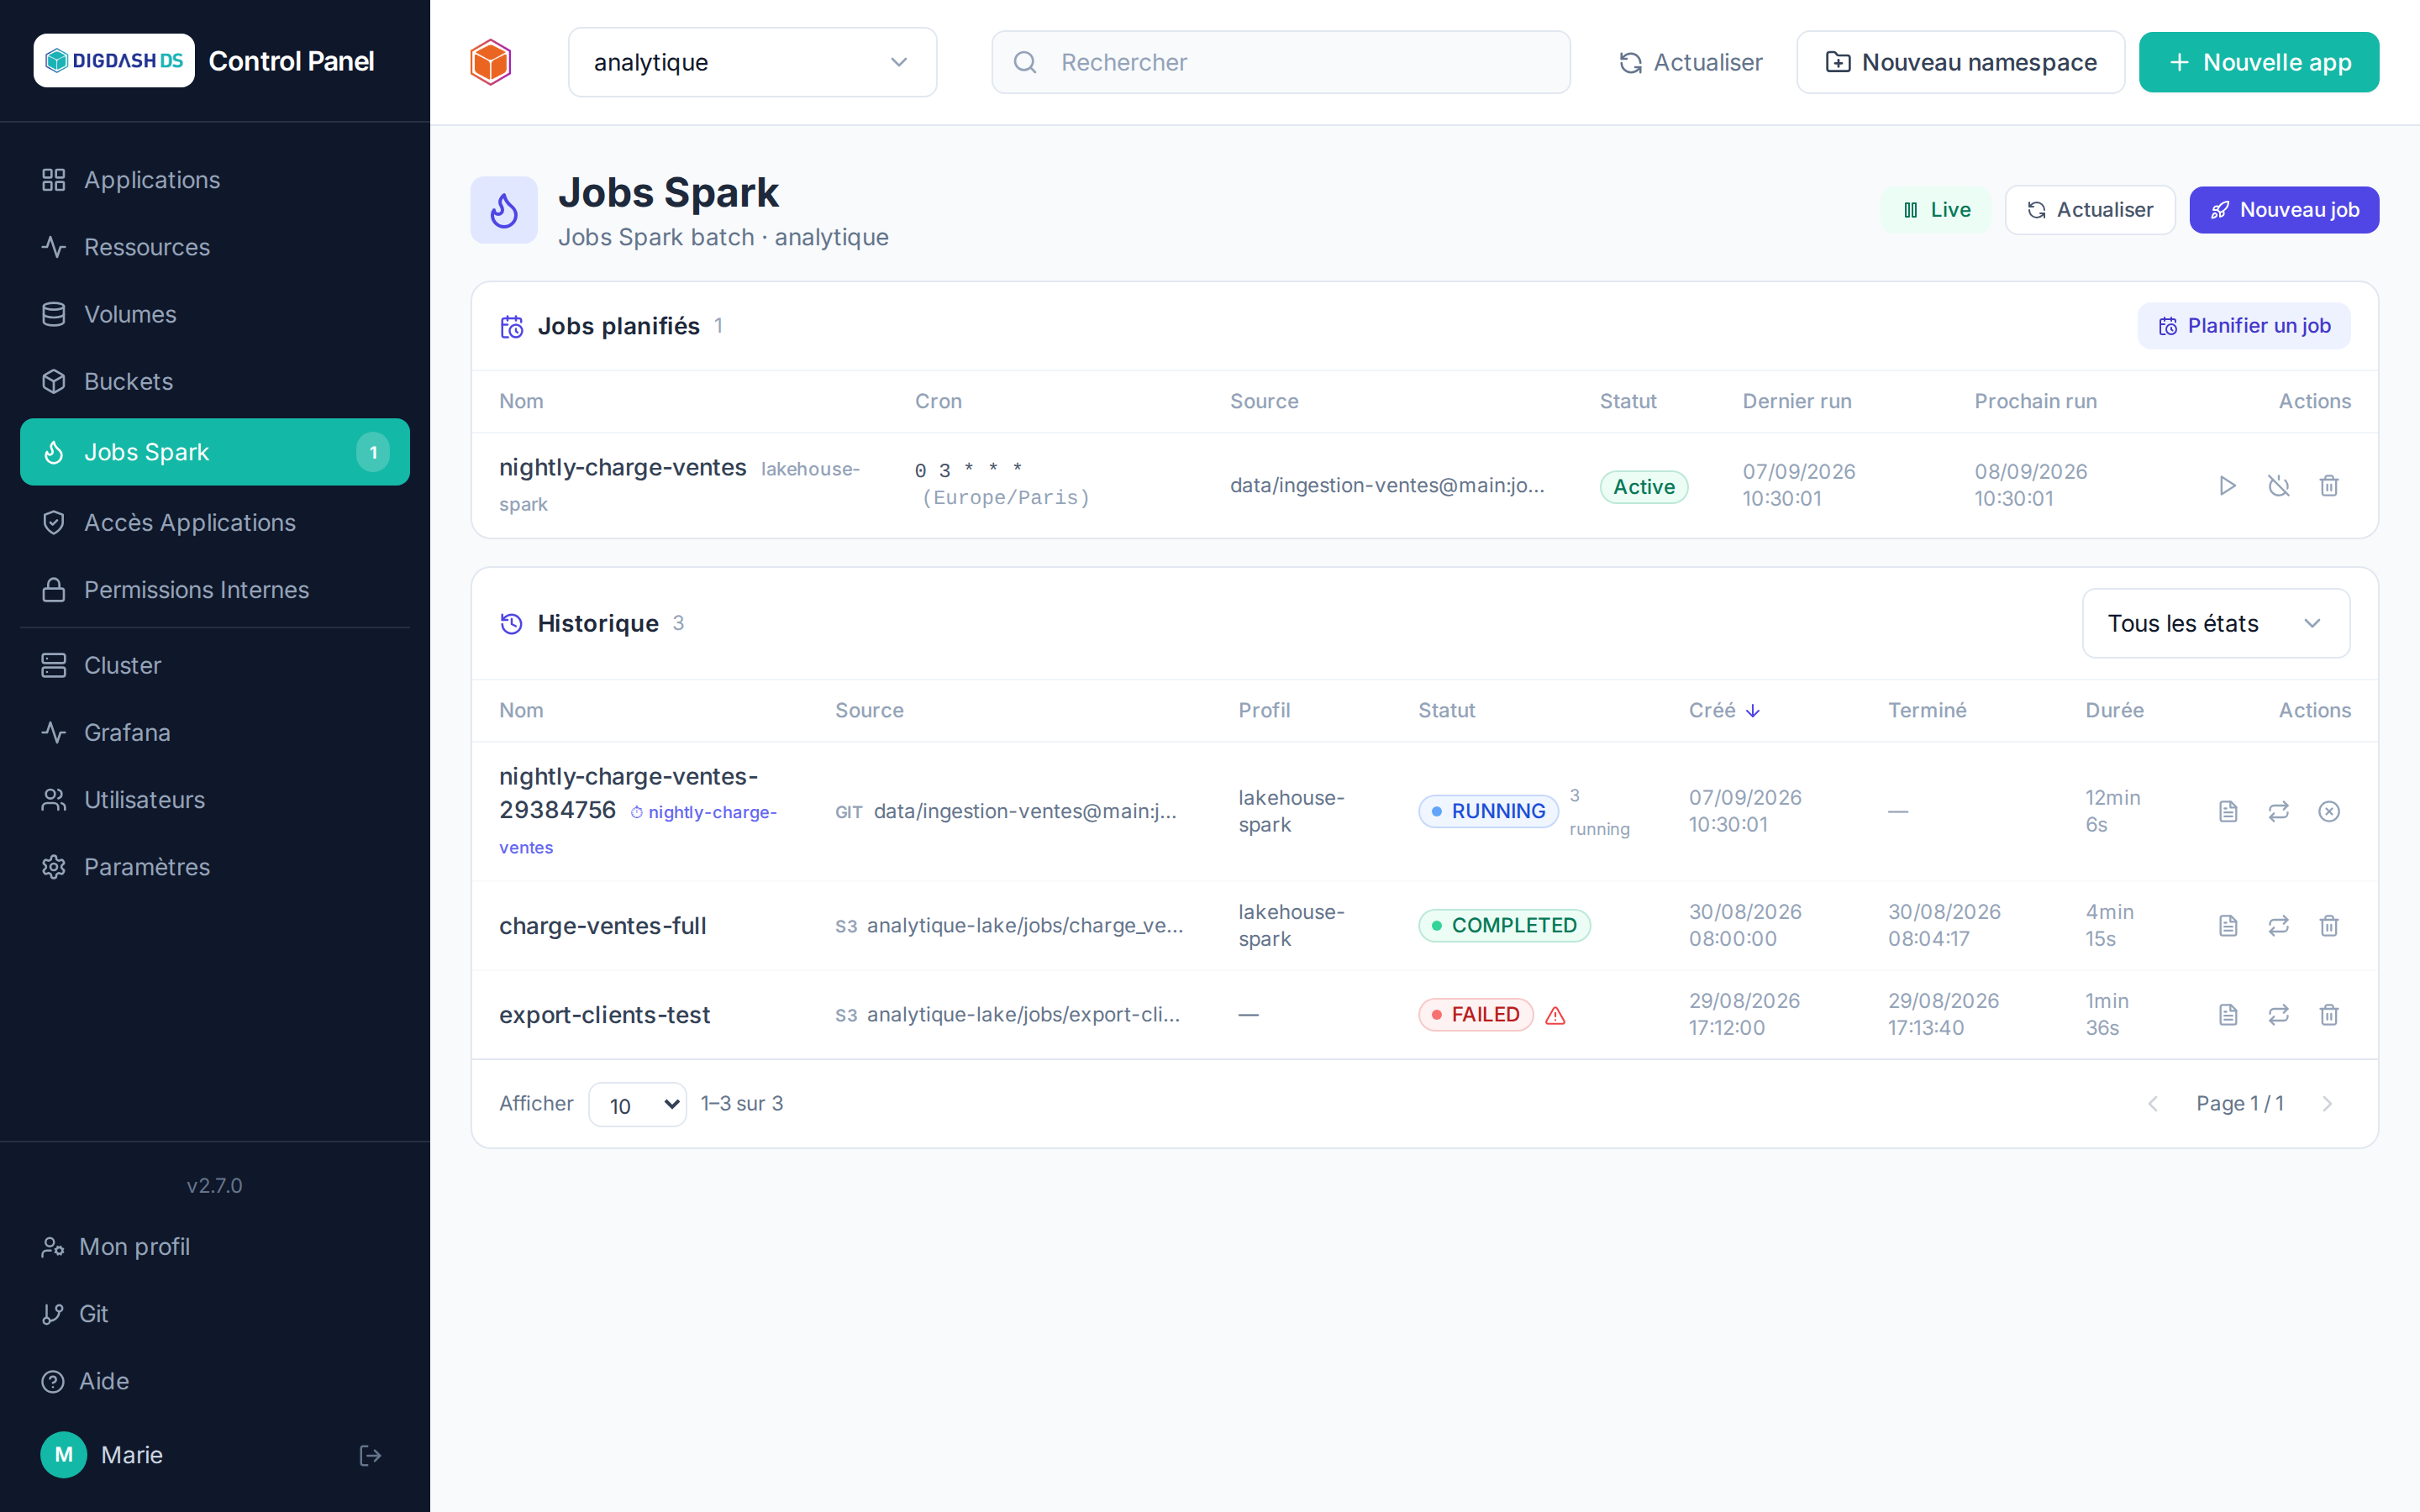
Pour les traitements Spark autonomes ou planifiés (hors session interactive Spark Connect), la page Jobs Spark de la barre latérale lance et suit des jobs batch dans le namespace courant, via le Kubeflow Spark Operator installé sur la plateforme : chaque job est une ressource Kubernetes SparkApplication du namespace (ou ScheduledSparkApplication pour une planification cron), dont l'opérateur lance le driver puis les exécuteurs en pods et nettoie à la fin. Le bouton Jobs Spark d'une carte Spark Connect ouvre la même page, filtrée sur cette instance comme profil.
Lancer un job
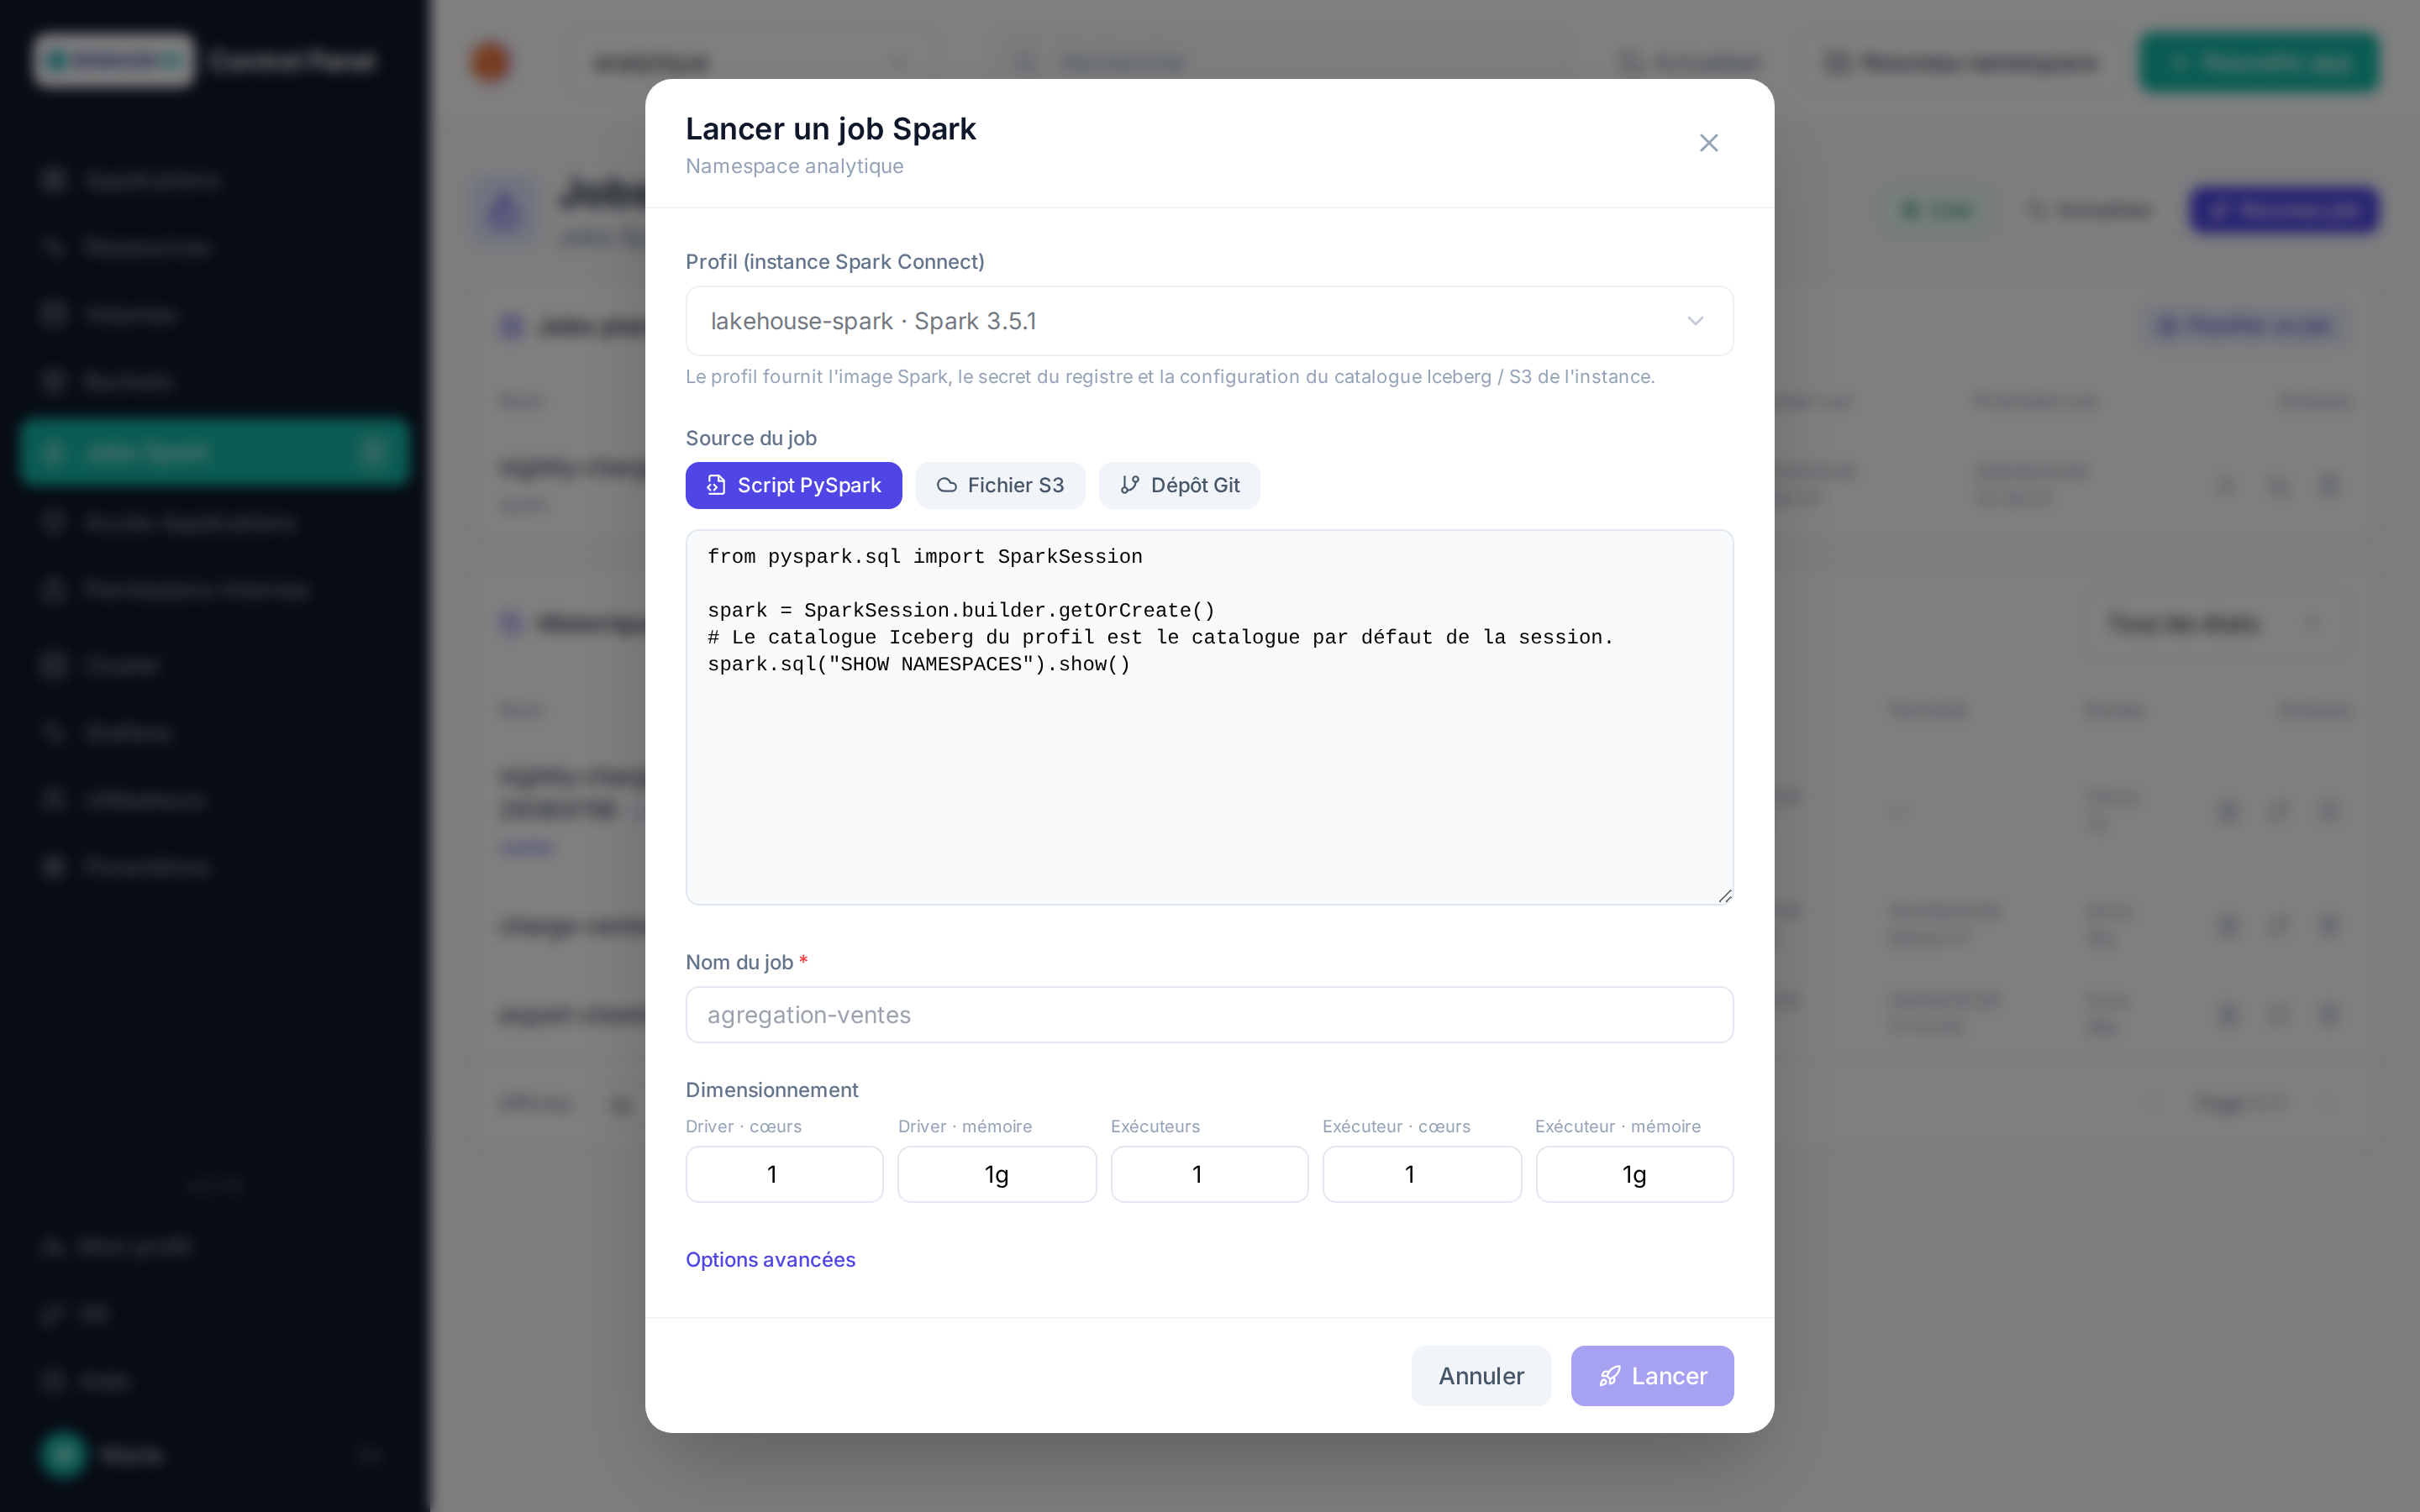
Nouveau job ouvre le formulaire :
| Champ | Rôle |
|---|---|
| Profil | Une instance Spark Connect du namespace : le job reprend son image Spark (jars Iceberg inclus), son secret de registre et la configuration de son catalogue Apache Iceberg / S3 (catalogue par défaut de la session). Sans profil, indiquez une image Spark explicite (et son secret de registre). |
| Source | Le fichier principal du job : un script PySpark saisi directement, un fichier S3 (bucket du namespace + chemin de l'objet ; endpoint et clés remplis par le sélecteur de bucket), ou un fichier d'un dépôt Git Forgejo (instance, dépôt, branche, chemin — cloné avec votre jeton personnel, voir Git). Une classe principale (options avancées) bascule en job Scala/Java sur un .jar. |
| Nom | Identifiant Kubernetes du job (minuscules, chiffres, tirets) — proposé à partir du fichier. |
| Dimensionnement | Cœurs et mémoire du driver, nombre d'exécuteurs, cœurs et mémoire par exécuteur. |
| Options avancées | Arguments, propriétés Spark supplémentaires (spark.*), rétention de la ressource après la fin — en heures, 168 (7 jours) par défaut. |
Le driver tourne avec le compte de service spark du namespace (limites CPU/mémoire posées sur chaque conteneur, comme l'exige le quota du namespace) ; les sources S3 et Git sont récupérées par un initContainer (aws s3 cp / git clone) dans un volume monté sur /opt/job, le script saisi via un ConfigMap sparkjob-<nom>. Les identifiants (catalogue, S3, Git) restent dans des Secrets du namespace, jamais dans le formulaire annoté sur la ressource.
Suivi
L'historique liste les jobs du namespace avec leur état (SUBMITTED, RUNNING, COMPLETED, FAILED…), leur source, leur profil et leur durée ; il se rafraîchit seul tant qu'un job est actif. Pour chaque job :
- Détail et logs : pods driver/exécuteurs et dernières lignes du driver, en direct tant que le job tourne ;
- Relancer à l'identique : nouvelle ressource
<nom>-<suffixe>à partir du formulaire d'origine (profil ré-résolu, donc image et configuration à jour) ; Relancer avec modifications rouvre le formulaire pré-rempli ; - Annuler (job actif) arrête driver et exécuteurs ; Supprimer (job terminé) retire la ressource et ses logs.
Les rôles habituels s'appliquent : lecture pour un viewer, lancement/annulation/suppression pour un operator, planification pour un admin du namespace.
Jobs planifiés
Planifier un job reprend le formulaire de lancement avec une expression cron (5 champs), un fuseau horaire, une politique de concurrence (interdire le chevauchement, autoriser, remplacer) et le nombre de runs conservés. Chaque planification peut être lancée immédiatement, suspendue puis réactivée, ou supprimée ; ses runs apparaissent dans l'historique avec le marqueur ⏱ du nom de la planification.
Sans l'interface
Les ressources restent manipulables avec kubectl -n <namespace> get sparkapplications : un job créé à la main apparaît dans l'historique (annulation/suppression possibles, mais pas de relance faute de formulaire d'origine). Sur un cluster sans accès à Docker Hub, les images des initContainers se surchargent dans Paramètres cluster : SPARK_JOB_GIT_IMAGE (défaut alpine/git) et SPARK_JOB_S3_IMAGE (défaut amazon/aws-cli).
Namespaces créés avant l'opérateur
Le compte de service spark est posé à la création de chaque namespace et vérifié à chaque lancement ; pour les namespaces antérieurs à l'installation de l'opérateur, l'installation le crée aussi (ou python manage.py ensure_spark_rbac côté ControlPanel).