Lakehouse : Apache Iceberg, Trino et JupyterHub
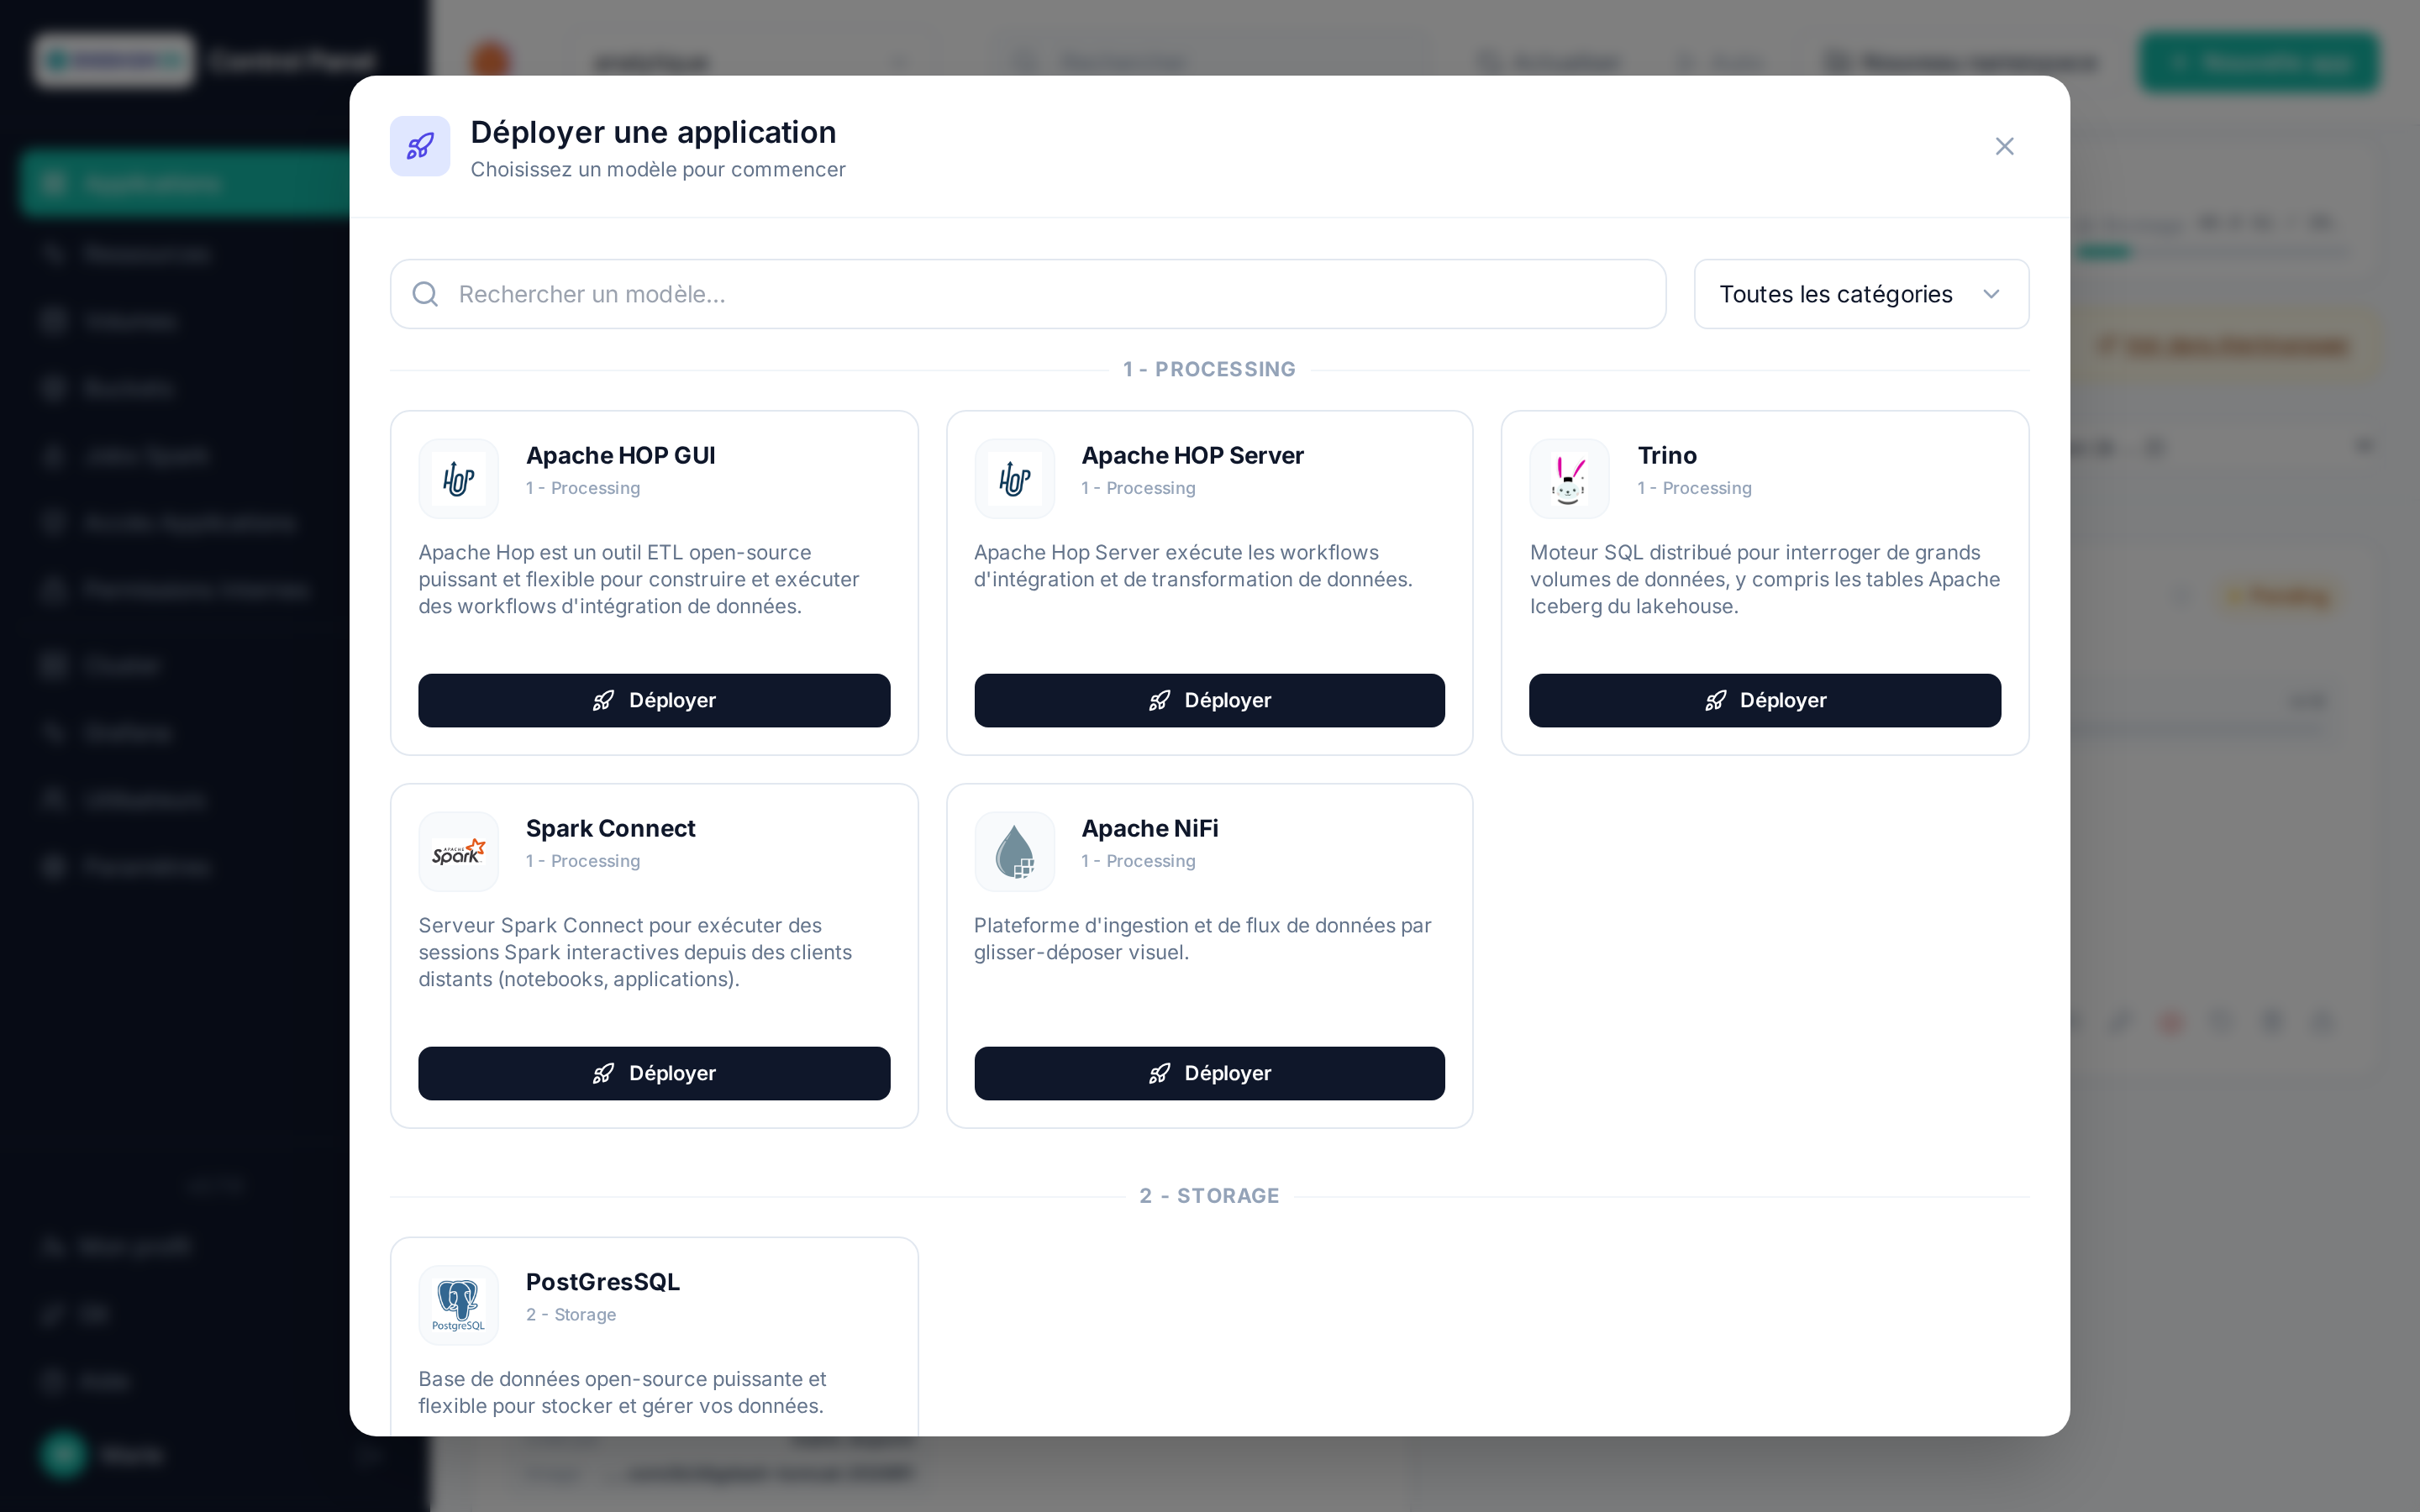
Six templates du catalogue forment ensemble un lakehouse sur les buckets S3 de la plateforme : un catalogue de tables Apache Iceberg (implémenté par Apache Polaris), le moteur SQL distribué Trino, des notebooks JupyterHub, un serveur Spark Connect, un serveur de tracking MLflow et Apache NiFi pour l'ingestion. Le catalogue se déploie en premier, le reste dans l'ordre voulu, dans le même namespace.
flowchart LR
    B[(Bucket S3<br/>warehouse)]
    P[Apache Iceberg<br/>catalogue Polaris]
    T[Trino]
    J[JupyterHub]
    S[Spark Connect]
    M[MLflow]
    N[Apache NiFi]
    T -- métadonnées --> P
    J -- métadonnées --> P
    P -- fichiers metadata --> B
    T -- données Parquet --> B
    J -- données --> B
    J -- Spark Connect --> S
    S -- métadonnées --> P
    S -- données --> B
    J -- runs --> M
    M -- artefacts --> B
    N -- ingestion --> B
Apache Iceberg (catalogue Polaris)
Le template Apache Iceberg (catégorie Gouvernance) déploie un catalogue Iceberg REST — Apache Polaris — adossé à une base PostgreSQL (CloudNativePG) créée avec lui.
| Champ | Rôle |
|---|---|
| Bucket S3 du warehouse (onglet Stockage, requis) | Bucket qui contiendra tables et métadonnées. Choisir un bucket du namespace remplit automatiquement endpoint, région et clés d'accès. |
| Nom du catalogue Iceberg | lakehouse par défaut : c'est le warehouse que Trino, Spark ou PyIceberg désignent. Fixé à la création. |
| Realm Polaris | POLARIS par défaut, un realm par instance. Fixé à la création. |
| Limite mémoire / CPU, Taille du stockage PostgreSQL | Capacité du serveur et de sa base. |
Au déploiement, deux tâches s'exécutent automatiquement : l'initialisation du realm (identifiants du principal root) puis la création du catalogue sur le bucket, avec les droits nécessaires. La carte passe en Running avant leur fin — comptez une à deux minutes de plus avant que le catalogue soit utilisable.
Identifiants du catalogue
Les moteurs s'authentifient auprès du catalogue avec le principal root, conservé dans le secret <nom>-root-principal du namespace (clés clientId, clientSecret, catalogUri, catalogName) — voir Secrets. Le catalogue ne distribue pas d'identifiants S3 temporaires (pas de STS sur le stockage objet de la plateforme) : chaque moteur utilise ses propres clés du bucket, d'où les champs S3 répétés dans les templates Trino et JupyterHub.
L'API REST est exposée sur https://<nom>-<namespace>.<domaine>/api/catalog (réservée aux appels authentifiés — pas d'interface web).
Trino
Le template Trino (catégorie Traitement) déploie un coordinateur et des workers Trino avec un catalogue lakehouse pré-câblé sur l'instance Apache Iceberg choisie.
| Champ | Rôle |
|---|---|
| Catalogue Apache Iceberg (Polaris) (requis) | Instance Apache Iceberg du même namespace. Fixé à la création. |
| Catalogue Iceberg (warehouse) | Nom du catalogue côté Polaris (lakehouse par défaut). |
| Bucket S3 du warehouse (onglet Stockage) | Le même bucket que celui du catalogue : sélectionnez-le pour remplir endpoint, région et clés. |
| Nombre de workers, Mémoire du coordinateur / par worker | Capacité. La mémoire d'un pod doit rester ≥ 3 Gi (heap JVM fixée à 1,4 Go, plus le hors-heap). |
La connexion se fait avec votre compte de la plateforme (OpenID Connect) : l'interface web https://<nom>-<namespace>.<domaine>/ui/ comme les clients SQL (trino --server https://… --external-authentication, JDBC avec externalAuthentication=true). Comme pour Apache Hop, l'accès est accordé depuis Accès aux utilisateurs ou groupes voulus — voir Accès et permissions.
Exemple, une fois connecté :
CREATE SCHEMA lakehouse.ventes;
CREATE TABLE lakehouse.ventes.commandes AS SELECT 1 AS id, 'test' AS libelle;
SELECT * FROM lakehouse.ventes.commandes;
Les fichiers Parquet et les métadonnées Iceberg apparaissent dans le bucket sous <schéma>/<table>-<uuid>/.
JupyterHub
Le template JupyterHub (catégorie Data science) donne à chaque utilisateur son propre serveur JupyterLab, avec un volume persistant personnel et la connexion via le compte de la plateforme. La personne qui déploie l'instance en est administratrice (/hub/admin).
| Champ | Rôle |
|---|---|
| Image des notebooks / Version | Image Jupyter des serveurs utilisateurs (ds/jupyter-datastack par défaut : JupyterLab + clients Spark Connect, PyIceberg, Trino, MLflow). |
| CPU / Mémoire max par utilisateur, Stockage par utilisateur | Capacité de chaque serveur ; le volume est créé au premier démarrage. |
| Catalogue Apache Iceberg, Trino, Spark Connect, MLflow (onglet Lakehouse, optionnels) | Instances du même namespace à pré-câbler dans les notebooks (variables d'environnement). |
| Bucket S3 (onglet Stockage, optionnel) | Clés S3 exposées aux notebooks (AWS_*). |
Variables disponibles dans chaque notebook quand le service correspondant est renseigné :
| Variable | Contenu |
|---|---|
POLARIS_URI, POLARIS_WAREHOUSE, POLARIS_CREDENTIAL, POLARIS_SCOPE |
Catalogue Iceberg REST et identifiants clientId:clientSecret |
TRINO_HOST |
Coordinateur Trino (nom:8080, accès interne au namespace) |
SPARK_REMOTE, MLFLOW_TRACKING_URI |
Spark Connect et MLflow (si déployés) |
AWS_ENDPOINT_URL, AWS_REGION, AWS_ACCESS_KEY_ID, AWS_SECRET_ACCESS_KEY |
Accès S3 au warehouse |
Exemple avec PyIceberg :
import os
from pyiceberg.catalog.rest import RestCatalog

catalog = RestCatalog(
    "lakehouse",
    uri=os.environ["POLARIS_URI"],
    warehouse=os.environ["POLARIS_WAREHOUSE"],
    credential=os.environ["POLARIS_CREDENTIAL"],
    scope=os.environ["POLARIS_SCOPE"],
    **{"s3.endpoint": os.environ["AWS_ENDPOINT_URL"],
       "s3.access-key-id": os.environ["AWS_ACCESS_KEY_ID"],
       "s3.secret-access-key": os.environ["AWS_SECRET_ACCESS_KEY"]},
)
print(catalog.list_namespaces())
Une instance JupyterHub par namespace
Le chart ne supporte qu'un JupyterHub par namespace ; un second déploiement est refusé avec un message explicite. Les serveurs utilisateurs inactifs depuis une heure sont arrêtés automatiquement (le volume personnel est conservé).
Spark Connect
Le template Spark Connect (catégorie Traitement) déploie un serveur Apache Spark en mode local (exécuteurs dans le pod) exposé par le protocole Spark Connect : les notebooks et clients PySpark du namespace partagent une seule installation Spark, déjà configurée sur le catalogue Apache Iceberg choisi. Pas de route publique (protocole gRPC interne au namespace).
| Champ | Rôle |
|---|---|
| Catalogue Apache Iceberg (Polaris) (requis) | Instance du même namespace ; catalogue Spark par défaut lakehouse. Fixé à la création. |
| Bucket S3 du warehouse (onglet Stockage) | Le même bucket que celui du catalogue : sélectionnez-le pour remplir endpoint, région et clés. |
| Cœurs Spark, Mémoire Spark (driver), Limite mémoire du pod | Capacité (local[N]) ; garder ~1 Gi de marge entre la mémoire Spark et la limite du pod. |
| Exiger un jeton de connexion | Jeton partagé (spark.connect.authenticate.token), conservé dans le secret <nom>-platform. Désactivé par défaut. |
Depuis un notebook JupyterHub rattaché (SPARK_REMOTE pré-rempli) ou tout client pyspark-client de la même version mineure que le serveur :
from pyspark.sql import SparkSession
spark = SparkSession.builder.remote(os.environ["SPARK_REMOTE"]).getOrCreate()
spark.sql("CREATE TABLE lakehouse.demo.t (x INT) USING iceberg")
spark.sql("SELECT * FROM lakehouse.demo.t").show()
MLflow
Le template MLflow (catégorie Data science) déploie un serveur de tracking MLflow : expériences, runs et registre de modèles dans une base PostgreSQL (CloudNativePG) créée avec lui, artefacts servis par le serveur sur un bucket S3. L'accès web est protégé par le login de la plateforme (le serveur MLflow n'a pas d'authentification propre) : comme pour Apache Hop, les utilisateurs et groupes autorisés se gèrent depuis Accès.
| Champ | Rôle |
|---|---|
| Bucket S3 des artefacts (onglet Stockage, requis) | Bucket (et préfixe, mlflow par défaut) des artefacts. Fixé à la création. |
| Processus serveur | Nombre de workers du serveur. |
| Limite mémoire / CPU, Taille du stockage PostgreSQL | Capacité. |
Depuis un notebook rattaché (MLFLOW_TRACKING_URI pré-rempli, accès interne sans login) : import mlflow; mlflow.set_tracking_uri(os.environ["MLFLOW_TRACKING_URI"]); mlflow.log_metric("accuracy", 0.99). Les artefacts transitent par le serveur : les notebooks n'ont pas besoin des clés S3.
Apache NiFi
Le template Apache NiFi (catégorie Traitement) déploie un nœud NiFi 2 (sans ZooKeeper) avec connexion par le compte de la plateforme : la personne qui déploie l'instance est l'administrateur initial et autorise les autres comptes depuis l'interface NiFi (menu Users / Policies). Le flow et les dépôts (FlowFiles, contenu, provenance, état) sont sur un volume persistant.
| Champ | Rôle |
|---|---|
| Heap JVM, Limite mémoire / CPU | Capacité ; garder ~1 Gi de marge entre le heap et la limite. |
| Taille du volume | Dépôts et flow. Fixé à la création. |
TLS de bout en bout
NiFi 2 n'écoute qu'en HTTPS : un certificat interne est généré au déploiement et vérifié par la passerelle de la plateforme. Le premier démarrage prend 1 à 3 minutes (chargement des extensions).
Jobs Spark batch (Spark Operator)
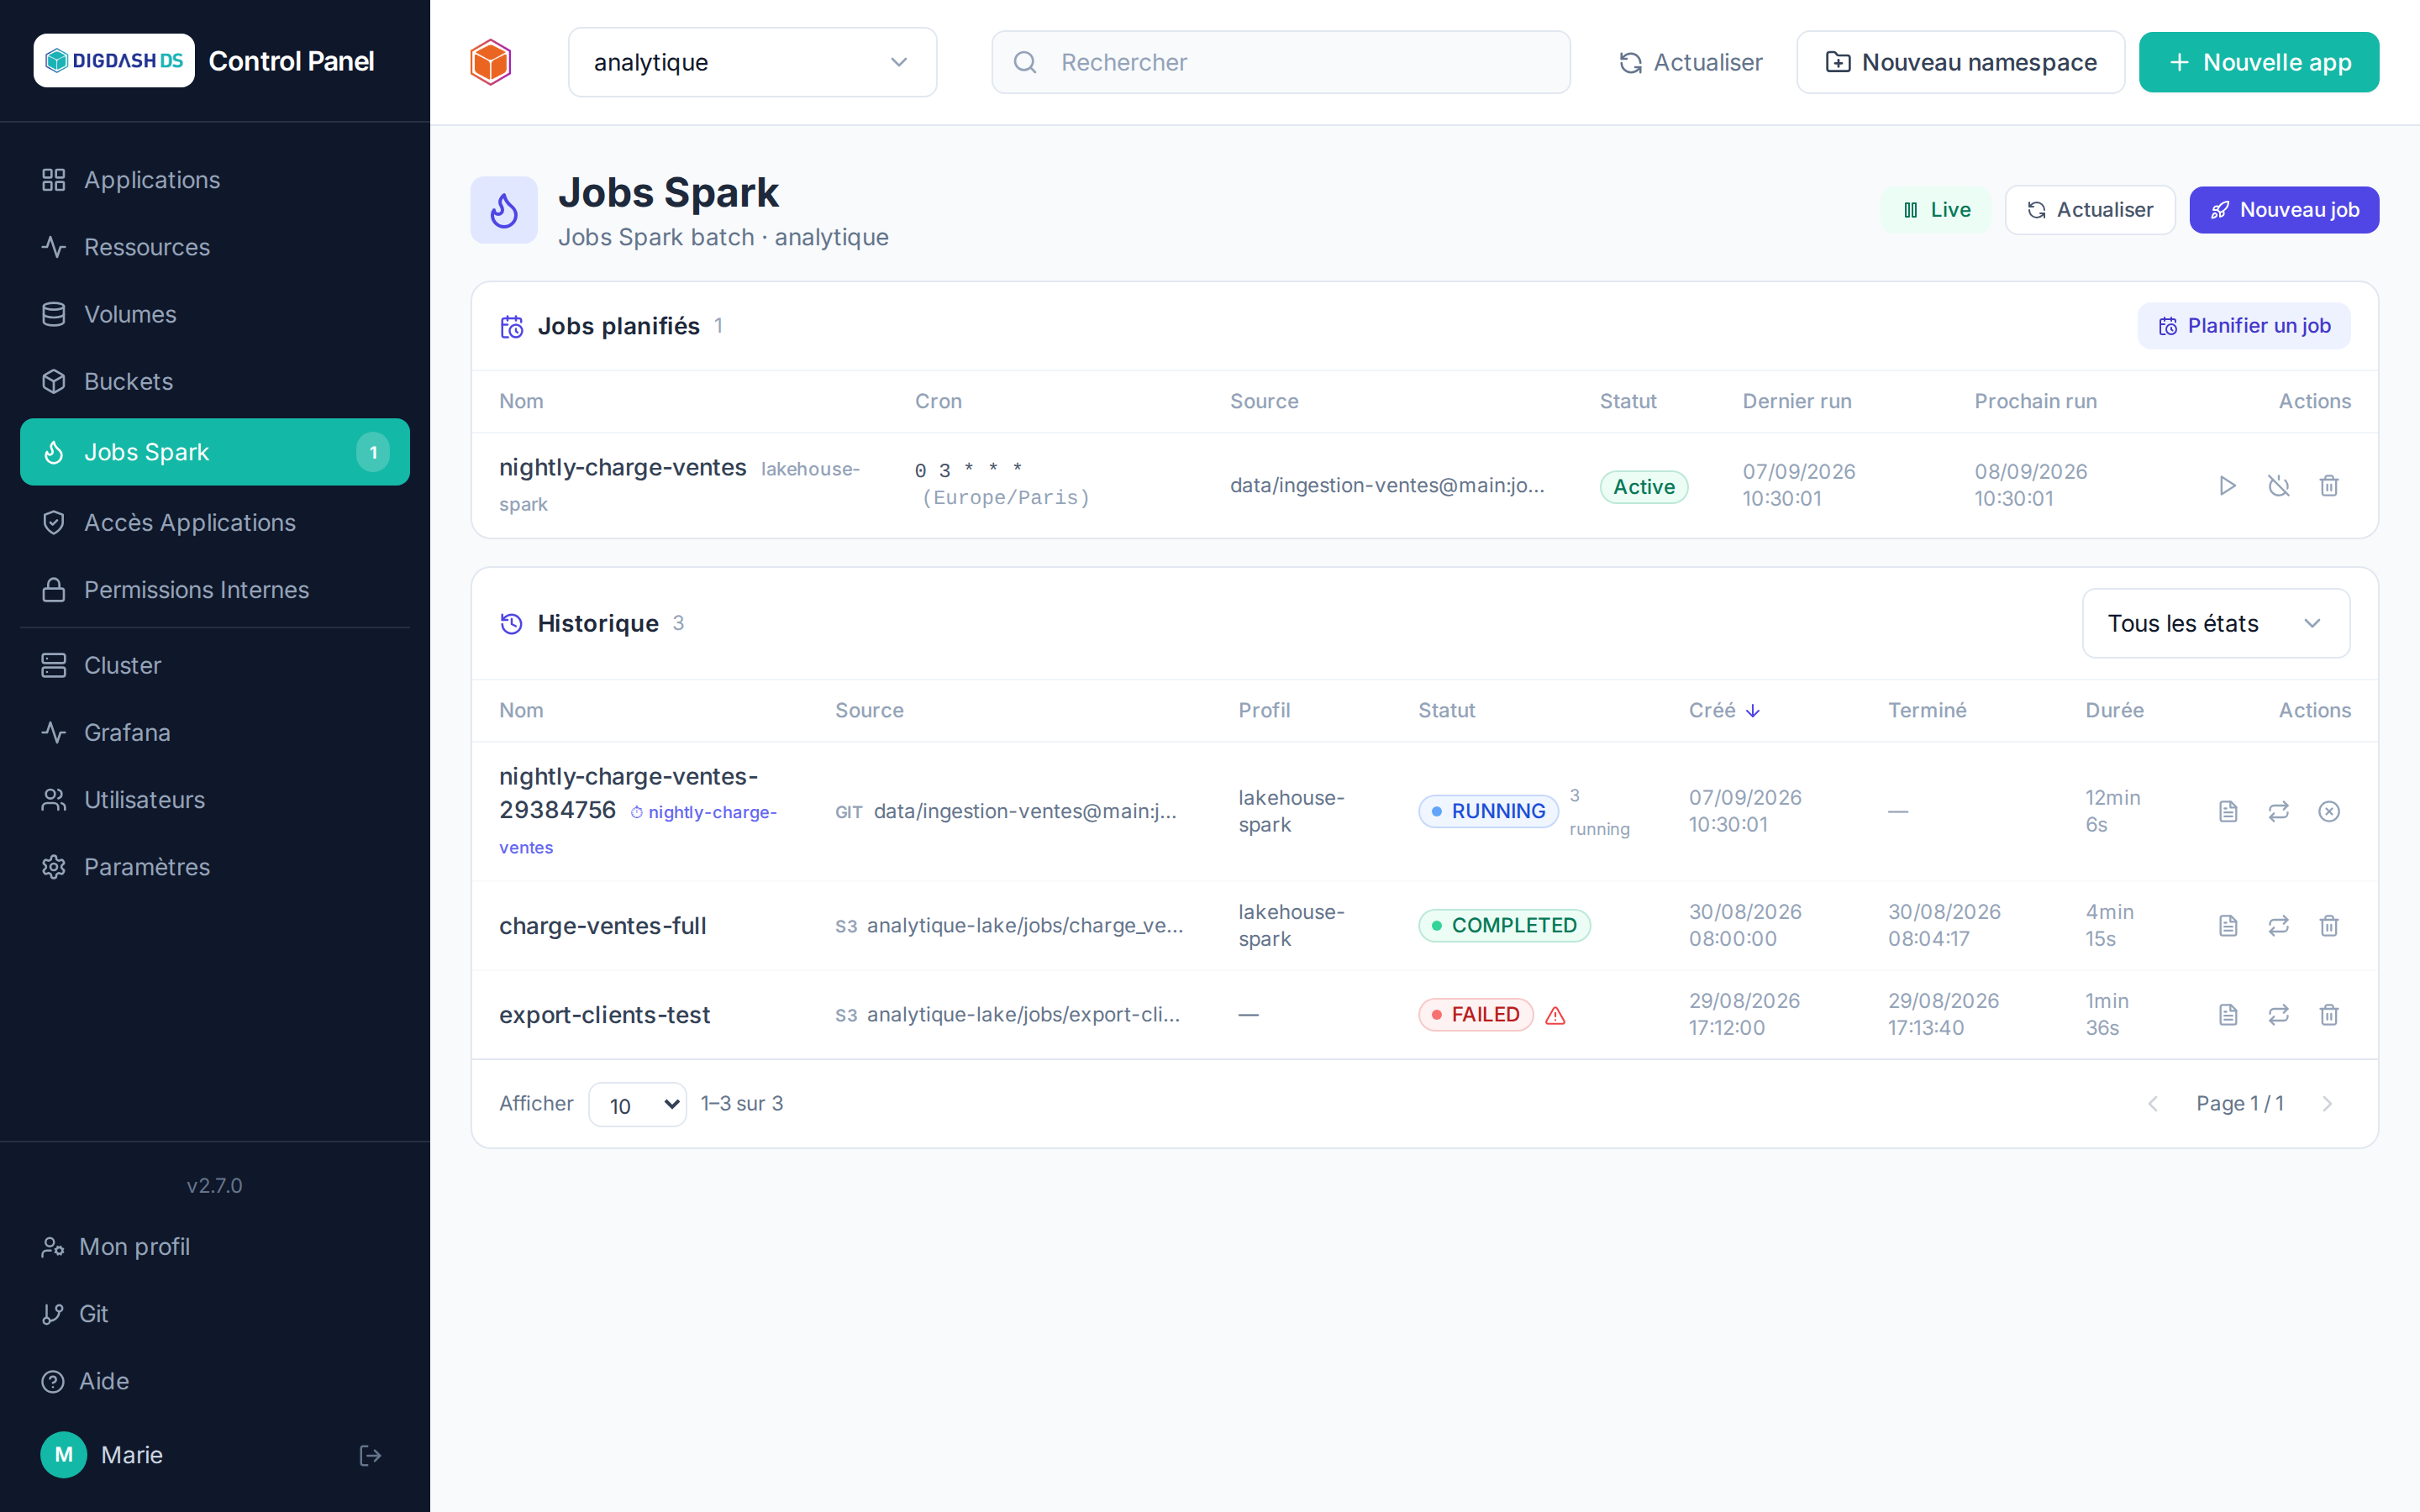
Pour les traitements Spark autonomes ou planifiés (hors session interactive Spark Connect), la page Jobs Spark de la barre latérale lance et suit des jobs batch dans le namespace courant, via le Kubeflow Spark Operator installé sur la plateforme : chaque job est une ressource Kubernetes SparkApplication du namespace (ou ScheduledSparkApplication pour une planification cron), dont l'opérateur lance le driver puis les exécuteurs en pods et nettoie à la fin. Le bouton Jobs Spark d'une carte Spark Connect ouvre la même page, filtrée sur cette instance comme profil.
Lancer un job
Nouveau job ouvre le formulaire :
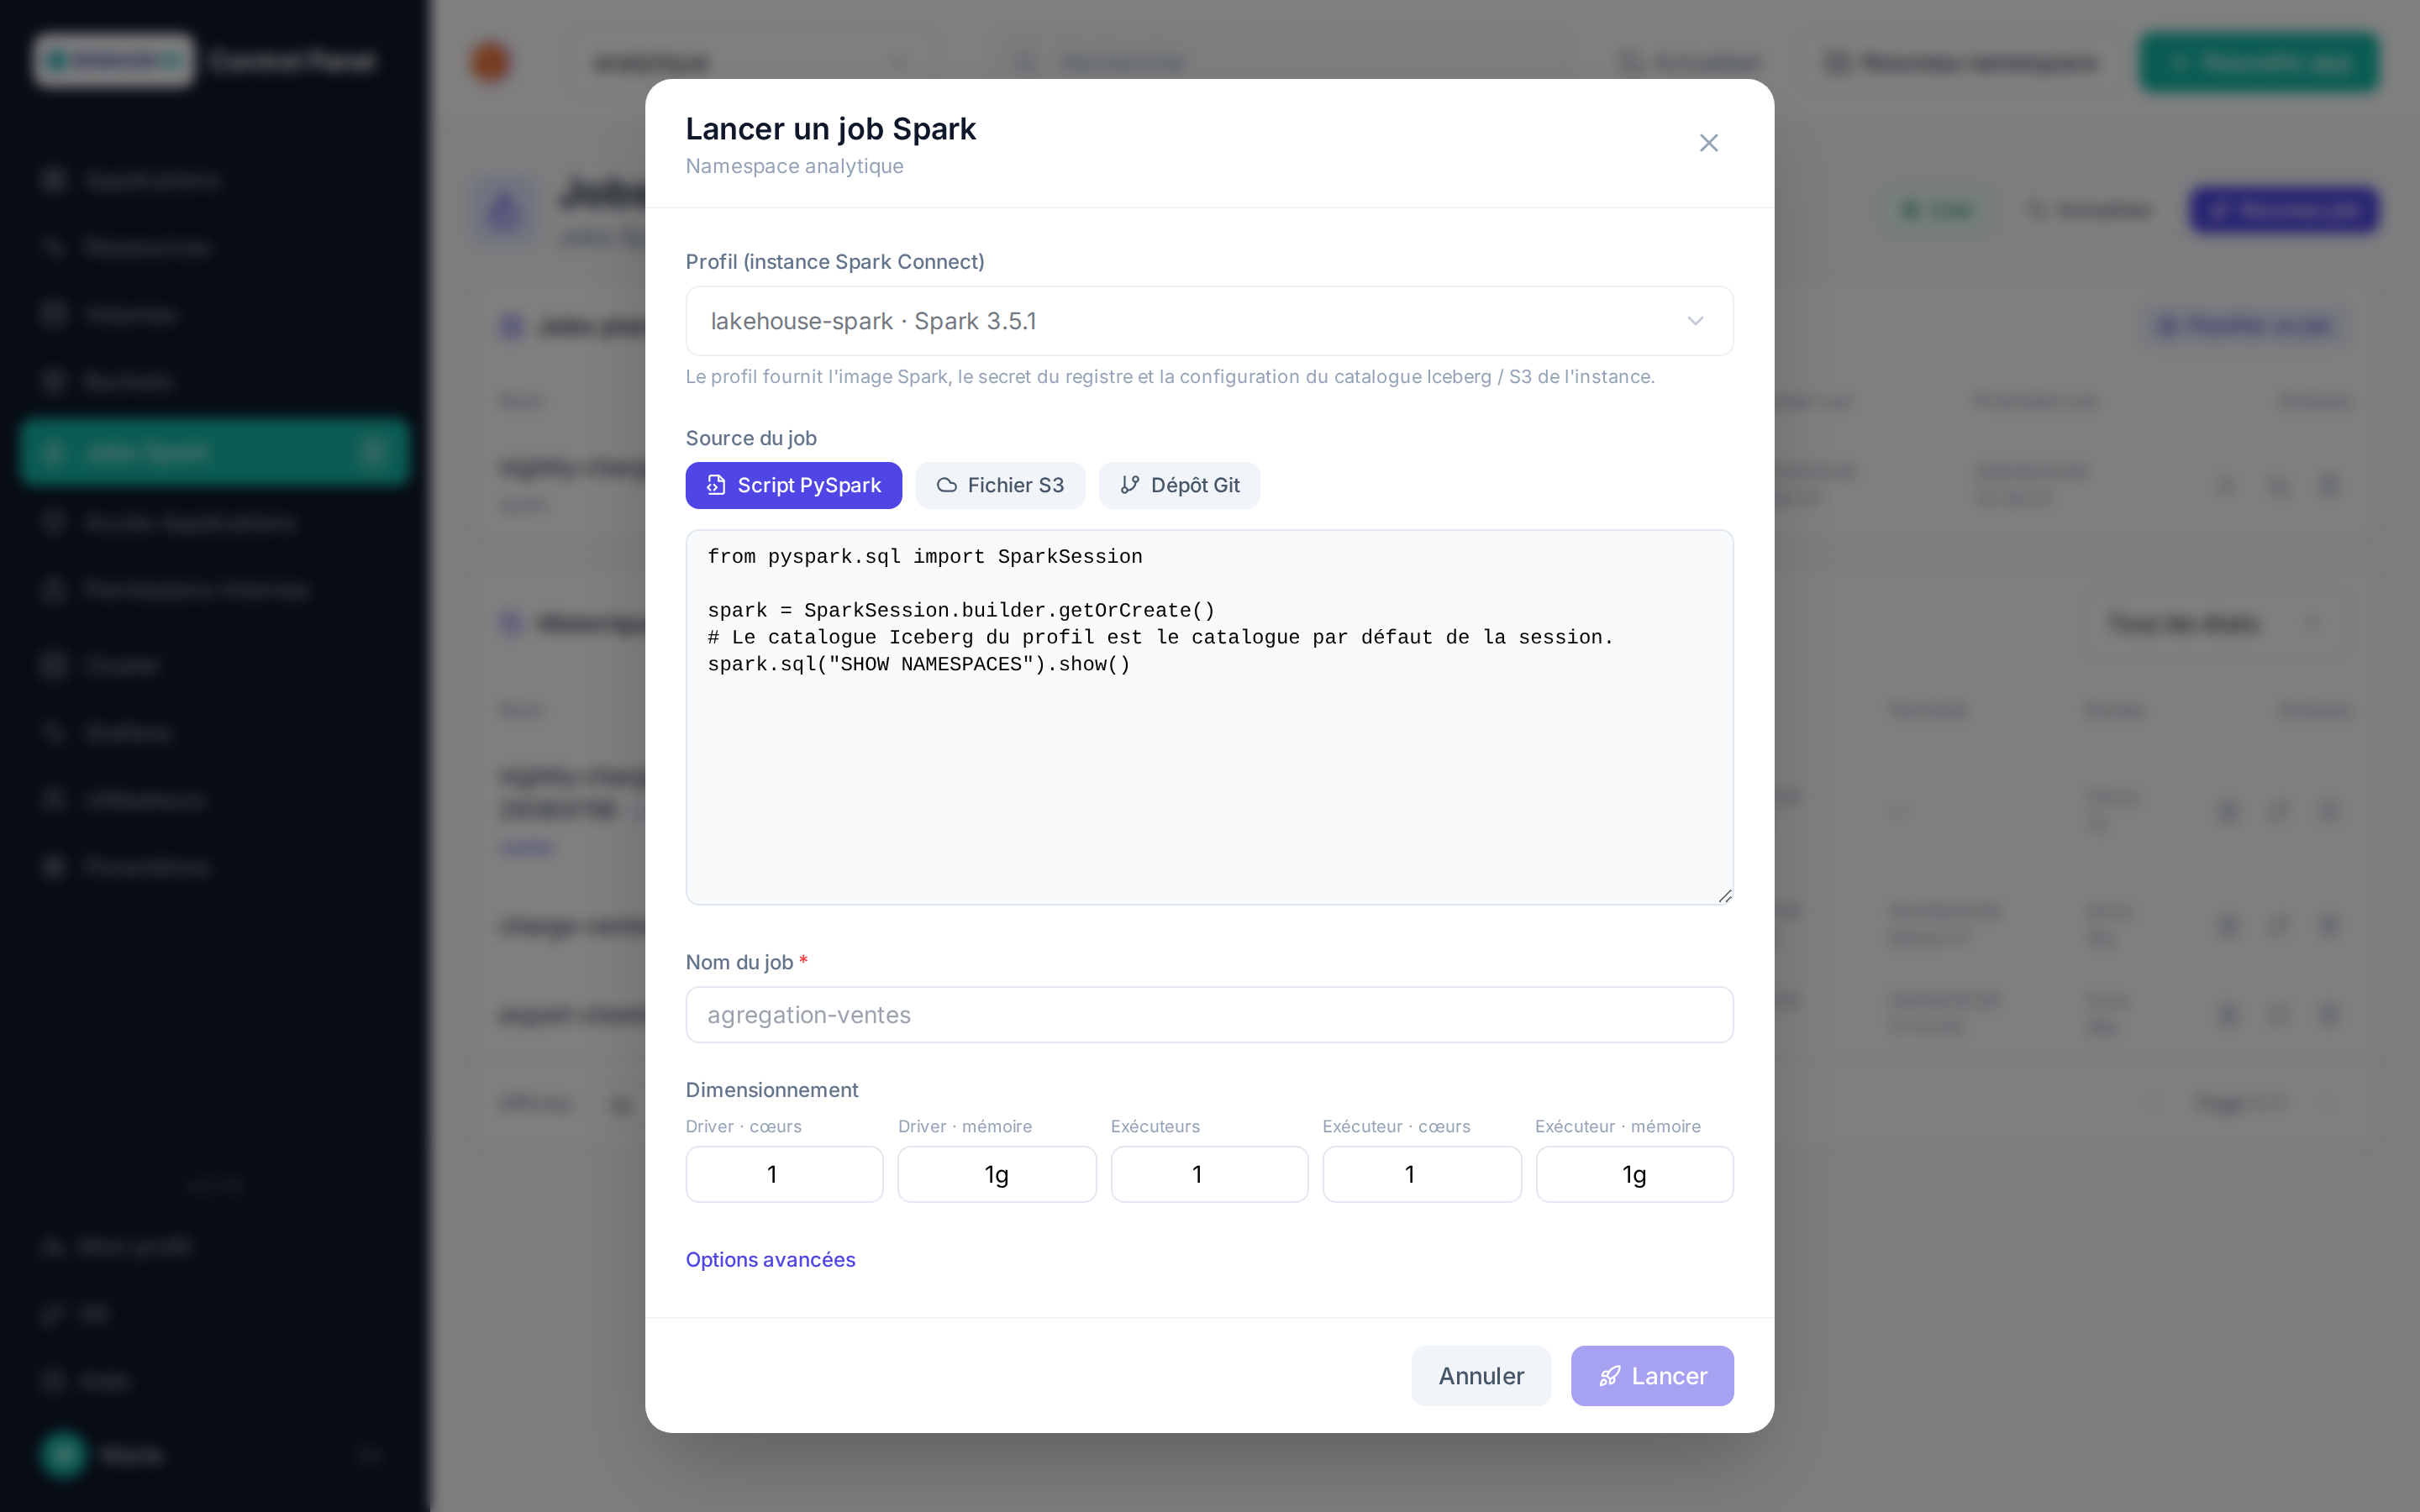
| Champ | Rôle |
|---|---|
| Profil | Une instance Spark Connect du namespace : le job reprend son image Spark (jars Iceberg inclus), son secret de registre et la configuration de son catalogue Apache Iceberg / S3 (catalogue par défaut de la session). Sans profil, indiquez une image Spark explicite (et son secret de registre). |
| Source | Le fichier principal du job : un script PySpark saisi directement, un fichier S3 (bucket du namespace + chemin de l'objet ; endpoint et clés remplis par le sélecteur de bucket), ou un fichier d'un dépôt Git Forgejo (instance, dépôt, branche, chemin — cloné avec votre jeton personnel, voir Git). Une classe principale (options avancées) bascule en job Scala/Java sur un .jar. |
| Nom | Identifiant Kubernetes du job (minuscules, chiffres, tirets) — proposé à partir du fichier. |
| Dimensionnement | Cœurs et mémoire du driver, nombre d'exécuteurs, cœurs et mémoire par exécuteur. |
| Options avancées | Arguments, propriétés Spark supplémentaires (spark.*), rétention de la ressource après la fin — en heures, 168 (7 jours) par défaut. |
Le driver tourne avec le compte de service spark du namespace (limites CPU/mémoire posées sur chaque conteneur, comme l'exige le quota du namespace) ; les sources S3 et Git sont récupérées par un initContainer (aws s3 cp / git clone) dans un volume monté sur /opt/job, le script saisi via un ConfigMap sparkjob-<nom>. Les identifiants (catalogue, S3, Git) restent dans des Secrets du namespace, jamais dans le formulaire annoté sur la ressource.
Suivi
L'historique liste les jobs du namespace avec leur état (SUBMITTED, RUNNING, COMPLETED, FAILED…), leur source, leur profil et leur durée ; il se rafraîchit seul tant qu'un job est actif. Pour chaque job :
- Détail et logs : pods driver/exécuteurs et dernières lignes du driver, en direct tant que le job tourne ;
- Relancer à l'identique : nouvelle ressource
<nom>-<suffixe>à partir du formulaire d'origine (profil ré-résolu, donc image et configuration à jour) ; Relancer avec modifications rouvre le formulaire pré-rempli ; - Annuler (job actif) arrête driver et exécuteurs ; Supprimer (job terminé) retire la ressource et ses logs.
Les rôles habituels s'appliquent : lecture pour un viewer, lancement/annulation/suppression pour un operator, planification pour un admin du namespace.
Jobs planifiés
Planifier un job reprend le formulaire de lancement avec une expression cron (5 champs), un fuseau horaire, une politique de concurrence (interdire le chevauchement, autoriser, remplacer) et le nombre de runs conservés. Chaque planification peut être lancée immédiatement, suspendue puis réactivée, ou supprimée ; ses runs apparaissent dans l'historique avec le marqueur ⏱ du nom de la planification.
Sans l'interface
Les ressources restent manipulables avec kubectl -n <namespace> get sparkapplications : un job créé à la main apparaît dans l'historique (annulation/suppression possibles, mais pas de relance faute de formulaire d'origine). Sur un cluster sans accès à Docker Hub, les images des initContainers se surchargent dans Paramètres cluster : SPARK_JOB_GIT_IMAGE (défaut alpine/git) et SPARK_JOB_S3_IMAGE (défaut amazon/aws-cli).
Namespaces créés avant l'opérateur
Le compte de service spark est posé à la création de chaque namespace et vérifié à chaque lancement ; pour les namespaces antérieurs à l'installation de l'opérateur, l'installation le crée aussi (ou python manage.py ensure_spark_rbac côté ControlPanel).
Suppression
Supprimer une instance Trino, JupyterHub, MLflow ou NiFi retire aussi son client OpenID de la plateforme ; supprimer Spark Connect ne touche à rien d'autre. Supprimer le catalogue Apache Iceberg supprime sa base PostgreSQL et ses secrets, mais pas les fichiers du bucket : les tables restent lisibles par un nouveau catalogue pointant sur le même emplacement, ou se nettoient depuis la page Buckets.